
FutureSim:在真实世界的回响中锻造“先知”型 AI 代理
FutureSim: Replaying World Events to Evaluate Adaptive Agents
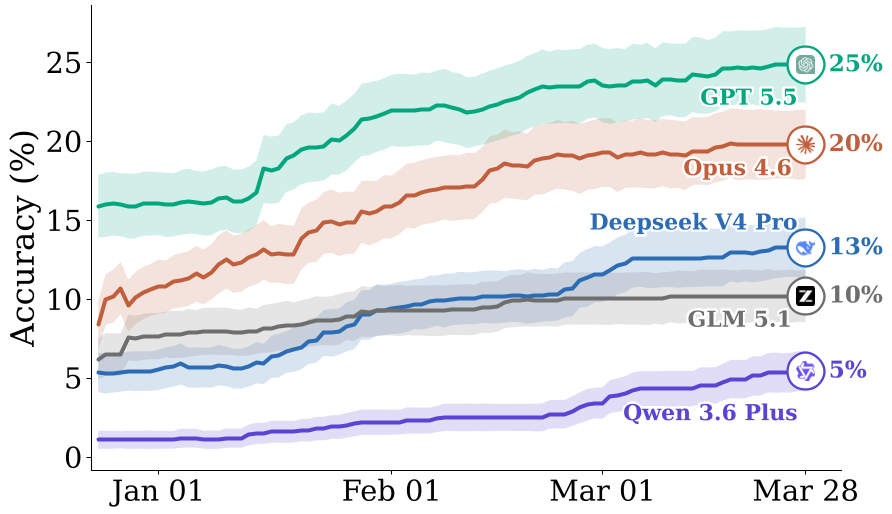
本文推出了 FutureSim,这是一个能够回放真实世界事件的时间轴模拟环境,旨在通过预测未来事件来评估 AI 代理的长程适应能力(Adaptive Agents)。研究对 GPT-5.5、DeepSeek-V4 Pro 等前沿模型进行了基准测试,其中 GPT-5.5 取得了 25% 的最高准确率,展现了其在动态环境下的适应潜力。
TL;DR
传统的 AI 评估正面临“静态黑箱”的困境:一旦模型训练完成,我们就很难衡量它在面对充满不确定性的未来时,能否像人类专家一样不断修正偏见。Transformer 的架构决定了它容易陷入“锚定效应”。为了打破这一僵局,来自马普所、ELLIS 研究所等的学者们提出了 FutureSim —— 一个基于 2026 年真实世界事件“回放”的仿真环境。它要求 AI 代理在长达 3 个月的时间跨度内,一边通过搜索获取新资讯,一边动态调整对未来事件的预测概率。
痛点深挖:为什么 LLM 很难“与时俱进”?
目前大多数 Agent 评测(如 GAIA 或 SWE-bench)是静态的。代理在处理任务时,环境状态往往是瞬时的。但在真实经济活动(如金融预测、政策分析)中,最核心的能力是 Test-time Adaptation(测试时适应):
- 知识截止效应:模型对训练截止日期后的世界一无所知。
- 长程记忆缺失:随着模拟时间推移(通常涉及几千次工具调用),早期的推理结论会被上下文窗口的“紧缩”或遗忘机制磨灭。
- 缺乏不确定性建模:模型往往倾向于给出肯定的错误答案,而非具有校准性的概率分布。
Methodology:FutureSim 的环境设计
FutureSim 的核心在于其时间轴一致性(Chronological Integrity)。
1. 架构解析
FutureSim 通过两个核心 Action 驱动模拟:
submit_forecast(qid, outcomes):代理提交对某个事件(如:谁将赢得 2026 年超级碗?)的概率预测。next_day():时间推进一天,环境更新当天发布的新闻语料库。
2. 严苛的沙盒机制
为了防止代理“偷看”答案,FutureSim 将新闻语料库(CCNews)进行本地物理隔离。代理无法访问实时互联网(防止通过当前时间点的信息反推 2026 年的“历史”),只能通过环境提供的搜索工具逐日探索。
实验与结果:GPT-5.5 的统治力与开源模型的挣扎
研究者测试了 GPT-5.5、Claude Opus 4.6、DeepSeek V4 Pro 以及 Qwen 3.6 等前沿模型。
核心战绩:
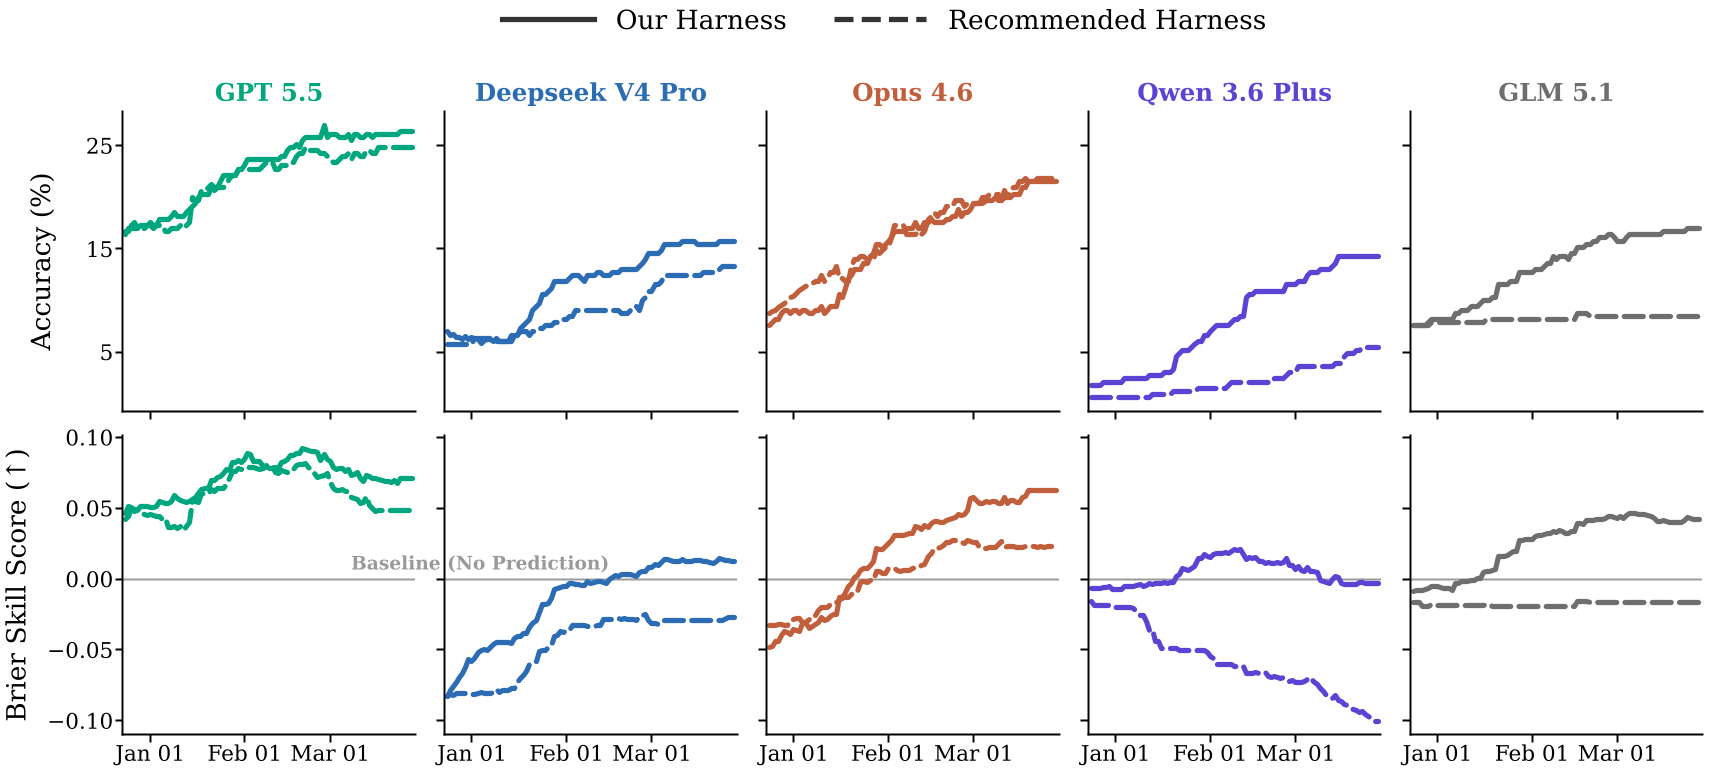
- GPT-5.5 在 Top-1 准确率(25%)和 Brier Skill Score (BSS) 上均远超竞争对手。BSS 是一项严苛的指标:完美预测得 1 分,弃权得 0 分,如果代理表现得自信而错误,则会得负分。
- 缺陷发现:大多数开源模型在默认 Harness(控制逻辑)下表现惨淡,BSS 甚至为负,这意味着它们在进行“误导性预测”。
自定义 Harness 的魔力
作者通过引入结构化存储工具(Structured Memory Tools)、**受迫记忆更新阶段(Forced Memory Phase)**以及上下文感知反馈,成功显著提升了 DeepSeek 和 Qwen 的预测校准度。这说明:即使基础模型稍弱,优秀的工程化“思维脚手架”也能在高复杂度长程任务中弥补差距。
深度洞察:AI 会成为超级预言家吗?
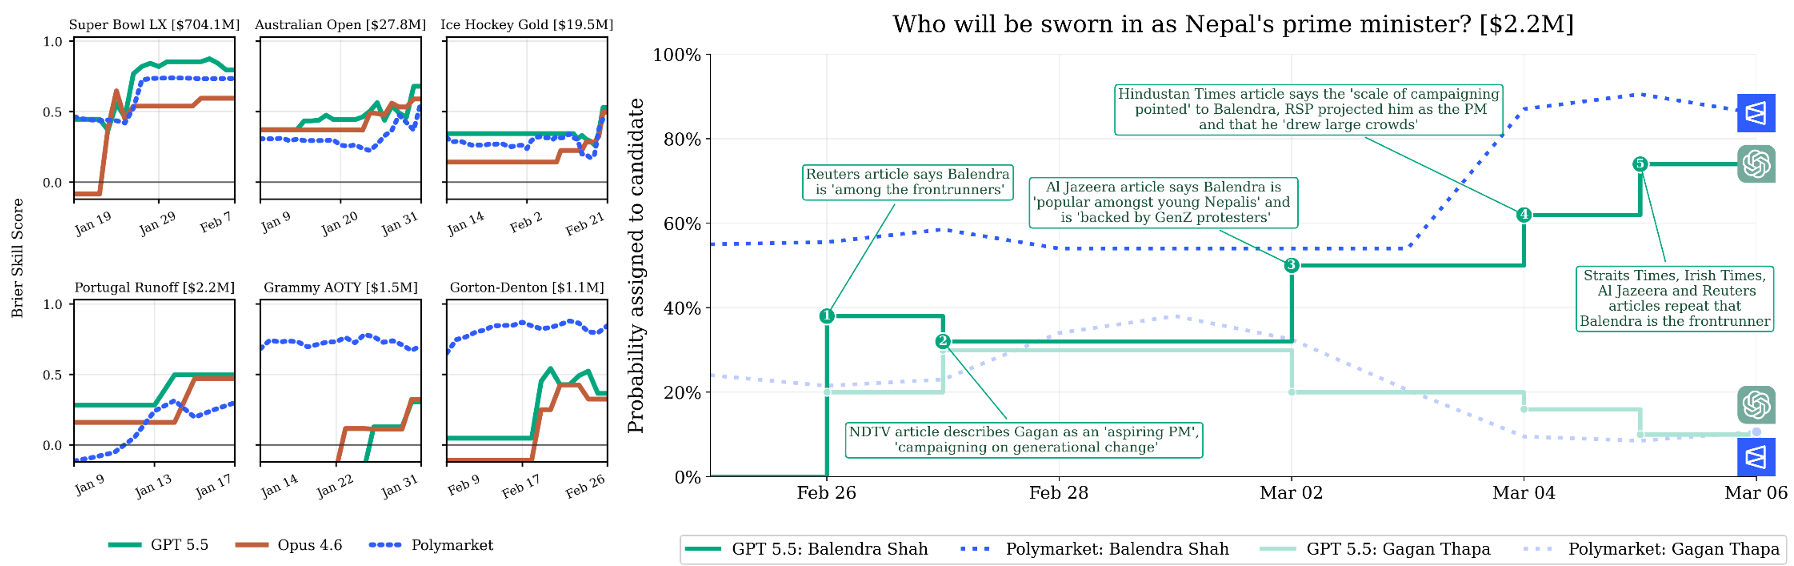
FutureSim 展示了一个迷人的现象:在某些案例中(如尼泊尔总理选举、超级碗赛果),GPT-5.5 的预测修正轨迹甚至领先于真实的预测市场(如 Polymarket)。
这篇论文给我们的启示:
- 推理的代价:高质量的预测依赖于超高的推理预算(Inference Scaling)。GPT-5.5 通过高达 4000 次的工具调用才换取了 25% 的胜率。
- 自我修正的难度:实验显示,即使明确告知代理之前的预测是错的,它们也往往会因为“先入为主”而难以动态修正锚定点。
- 多智能体协作:当多个 DeepSeek 模型在同一预测市场竞争时,它们的预测会逐渐趋同,展现了群体动力学(Multi-agent Dynamics)对单一决策质量的影响。
局限性与展望
尽管 FutureSim 提供了一个高度可重复的现实回放,但它目前仅限于“纯预测性”任务。这意味着代理的行为不会改变世界的走向(非干预性)。未来,如何将这种时间轴回放与更具交互性的决策环境(如模拟股市交易或外交博弈)结合,将是迈向真正 AGI 代理的必经之路。
总结: FutureSim 不仅仅是一个 Benchmark,它是一部“缩微的世界演化史”,时刻提醒着 AI 开发者:真正的智能,在于拥抱不确定性并在信息的洪流中精准进化。