
HALLUWORLD:当 LLM 遇上“模拟人生”,揭开幻觉背后的认知迷雾
HalluWorld: A Controlled Benchmark for Hallucination via Reference World Models
本文推出了 HALLUWORLD,这是一个基于“参考世界模型”理论构建的 LLM 幻觉评测基准。该基准涵盖 Gridworld、国际象棋及真实终端任务三大领域,通过可控的观察视图(View)和参考世界状态(Reference World),实现了幻觉错误的自动化标注与细分归因。
TL;DR
幻觉一直是 LLM 的顽疾,但我们真的了解它的本质吗?来自卡内基梅隆、斯坦福等机构的研究者提出了 HALLUWORLD。它不再通过堆砌静态题目来测幻觉,而是把模型扔进“模拟世界”(网格房、棋局、Linux 终端),通过监控模型对世界状态的理解偏差,首次实现了对幻觉的精准“手术级”解剖。
核心发现:主流模型(如 GPT-5.5, o3)已经玩转了“眼睛看得到的”事实,但在“大脑推演未来”和“承认自己不知道”上依然漏洞百出。更令人惊讶的是,Extended Thinking(长思维链)有时反而会诱发更严重的因果幻觉。
1. 痛点:为什么旧的评测方法失效了?
传统的幻觉评测(如 FactScore)通常是在比对“模型说的”和“文档写的”。这种方法有三大死穴:
- 静态局限:无法评估世界状态随时间变化(如:文件被删了,模型还记得旧路径)。
- 定义混乱:把记忆错误、逻辑错误和虚假事实全部混为一谈。
- 可评估性差:高度依赖人工标注或昂贵的 LLM-as-a-judge。
HALLUWORLD 的核心 Insight 是:幻觉本质上是模型内部那个“世界模型”崩塌了。 如果我们有一个上帝视角的模拟器作为 Ground Truth,幻觉就变成了可量化的物理位移。
2. 架构详解:构建“上帝视图”
HALLUWORLD 设立了三个极具代表性的领域:
- Gridworld:纯合成网格环境,测试空间推理、物体追踪(如:火扑灭了吗?)。
- Chess:高规则性领域,测试模型在复杂博弈状态下的规则遵守与跨步模拟。
- Terminal:真实感最强的 Linux 系统操作,测试模型在超长 Context (30k-60k tokens) 下的状态感知。
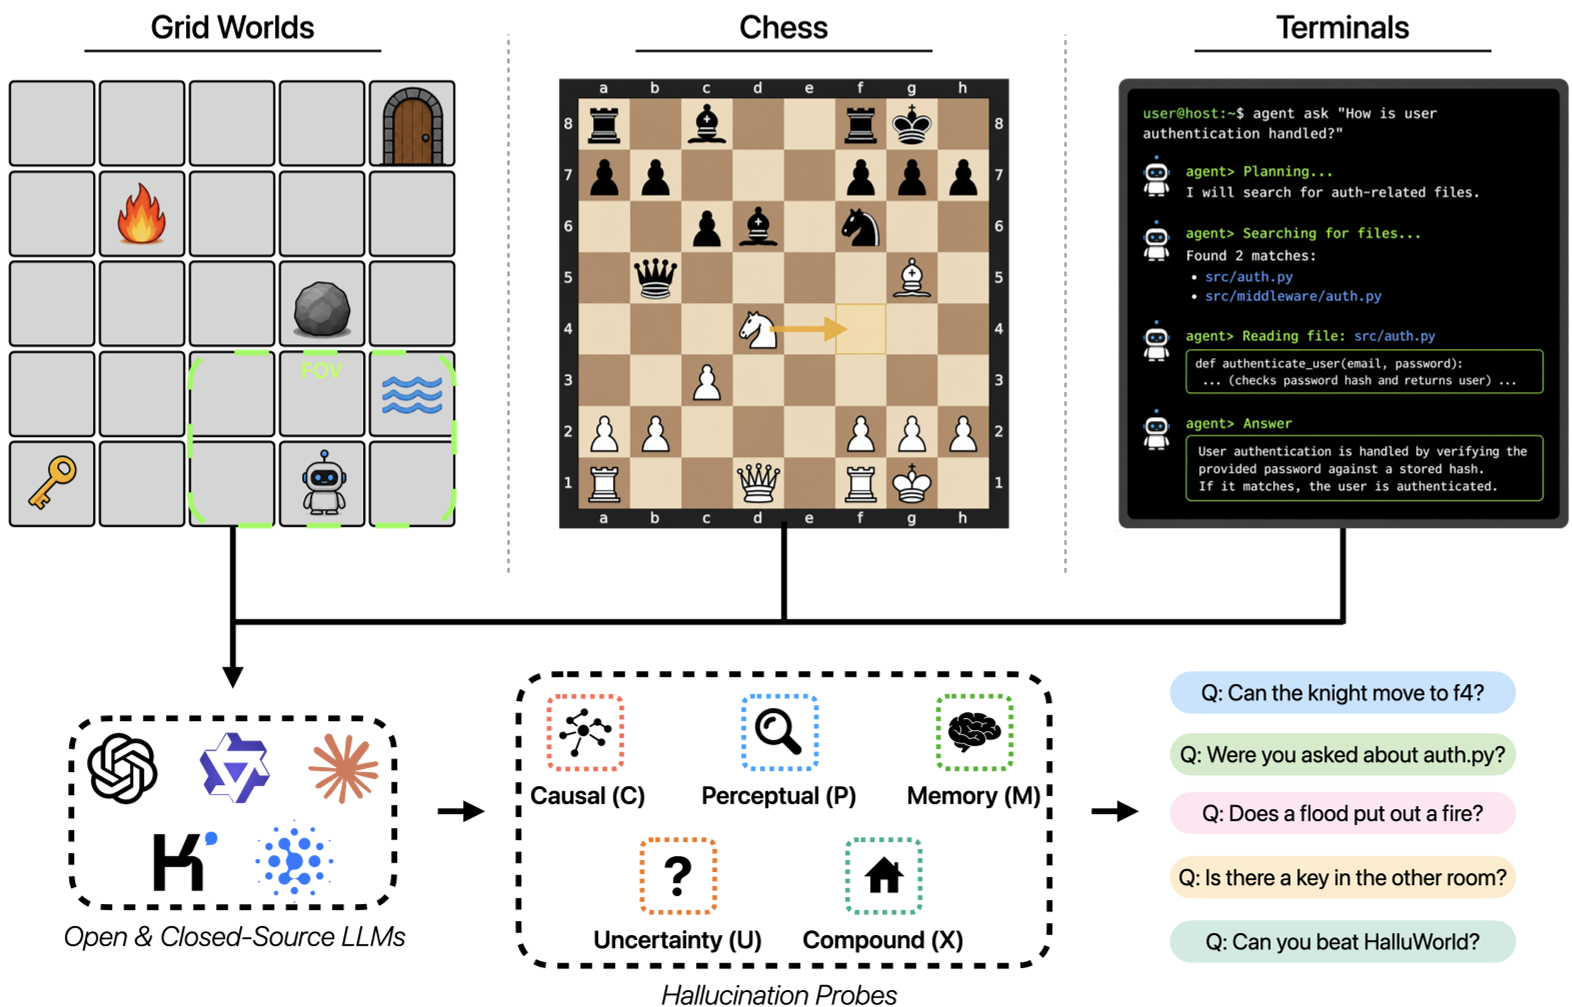 (图 1:HALLUWORLD 基准涵盖三个领域及五个核心认知维度)
五大探测维度 (Probes)
- Perceptual (P):当前时刻看到了什么?
- Memory (M):之前发生了什么?(状态追踪)
- Causal (C):如果我做了 A 会发生什么?(前向模拟)
- Uncertainty (U):证据不足时,模型敢不敢说“不知道”?
- Compound (X):多房间/多步骤的综合推理。
3. 核心实验与惊人发现:越思考,越幻觉?
研究团队评估了包括 GPT-5.5、o3、Claude 4.6 在内的全球顶尖模型。
3.1 性能分布:两层阶梯
实验结果表(Table 3)显示出明显的代际鸿沟:
- 推理级模型 (Thinking Models):GPT-5.5, o3, Claude Opus 4.6 组成的第一梯队,整体幻觉率控制在 5%-8% 左右。
- 普通模型:GPT-4o 及开源模型(如 GLM-5, DeepSeek-V3.1)则在 12%-15% 以上。
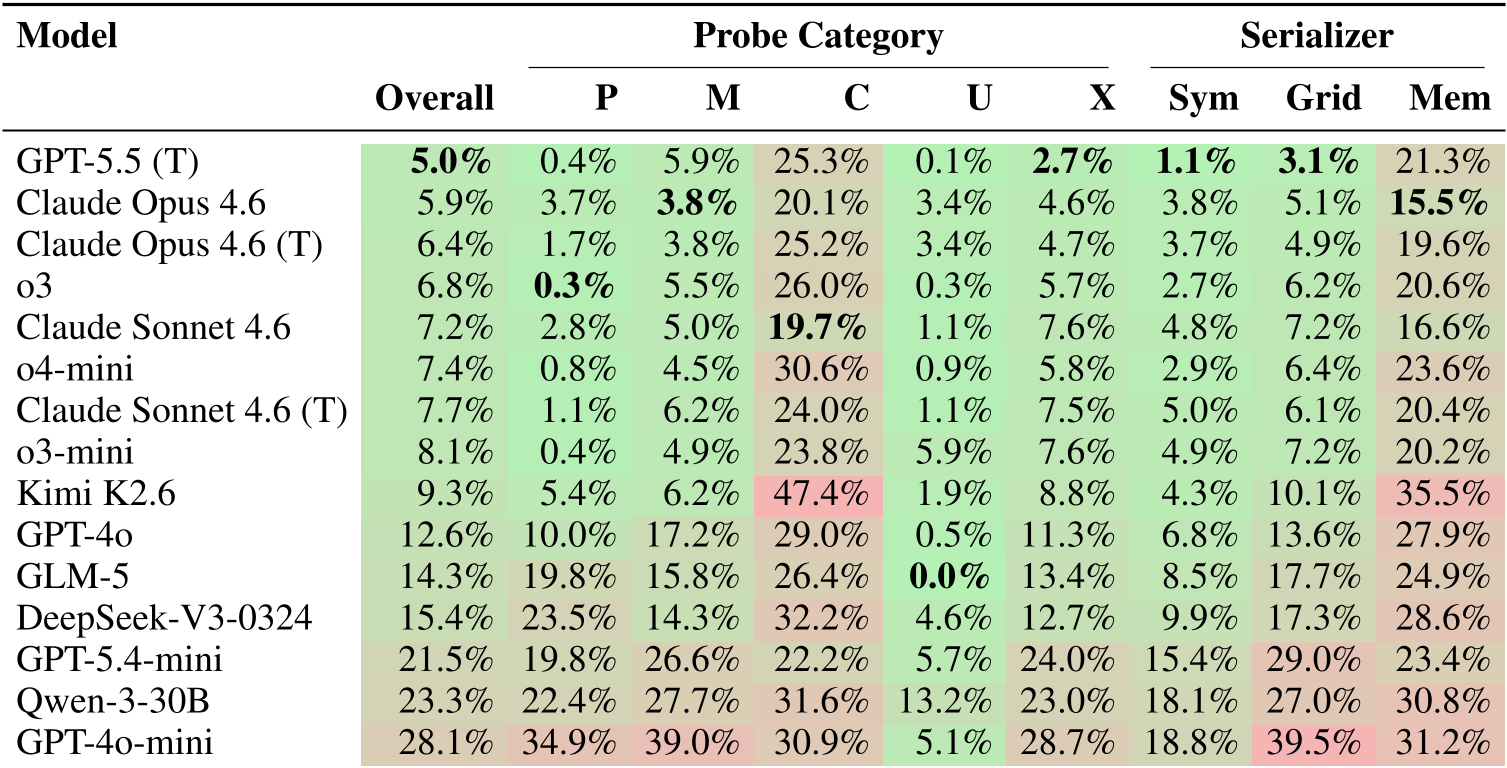 (表 3:各模型在不同认知维度下的幻觉率表现)
3.2 思维链的逆反效应 (Thinking Paradox)
这是一个突破直觉的发现:在 Causal (因果) 任务中,Claude Sonnet 4.6 增加推理步数后,幻觉率反而从 19.7% 上升到了 24.0%。
- 原因分析:感知类任务只需要仔细扫描,而因果任务需要模拟未来的状态。模型在推理过程中,往往会“脑补”出逻辑自洽但物理上不存在的中间状态。这说明对于因果推演,仅靠“思考”是不够的,还需要更强的物理规律锚定。
3.3 “文字”比“事实”更有诱惑力
实验发现,当环境中给出一个具有诱导性的“标志牌”时(即使标志牌是过时的或错误的),模型往往会优先选择相信文字,而忽略了观察到的物理现象(如:门明明开着,但牌子说门锁了,模型就会报告门锁了)。
4. 深度洞察:我们离“无幻觉”还有多远?
- 动态感知已解决,状态追踪仍是坑:目前的 Frontier Models 在读取当前屏幕信息上已经非常完美(P 维度准确率极高),但一旦涉及到“根据过去的操作推演当前文件的哈希值”这类 M/C 任务,即使是 GPT-5.5 也会产生明显波动。
- 不确定性的“过分自信”:在 Terminal 任务中,即使是最强的模型在处理“由于证据不足应拒绝回答”的问题时,也有近 1/4 的概率会编造出一个确定的答案。这在安全生产环境中是致命的。
- 序列深度效应:随着操作步骤的增加,幻觉呈线性增长。在复杂的 7 房间导航任务中,幻觉率甚至是基准水平的 5 倍以上。
5. 总结与反思
HALLUWORLD 告诉我们,幻觉不是 LLM 的“一个”问题,而是“一簇”问题。
- 对研发者的启示:不要迷信 Scaling Law 或更长的推理环节。提升模型对物理规律的敏感度、引入显式的状态更新机制(如外部 Memory 组件)可能是比 RAG 更有效的路径。
- 对应用者的启示:在交互式 Agent 任务中,尽量使用“符号化(Symbolic)”的简短信息传递,而非复杂的 ASCII 图形。
未来的 LLM 评测将不再是考卷上的选词填空,而是像 HALLUWORLD 这样,在真实世界的模拟沙盘中,考察模型是否真的“理解”了万物的运行逻辑。