
LLM 的“心事”你别猜:通过动力系统理论解密大模型的不可观测性与木马风险
Meanings and Feelings of Large Language Models: Observability of Latent States in Generative AI
本文将大语言模型(LLMs)建模为动力系统,研究其潜状态的“可观测性”(Observability)。研究指出,在没有隐藏系统提示词的情况下,Transformer 架构的 LLM 是完全可观测的;而引入系统提示词(System Prompts)后,模型将产生不可观测的“思维”轨迹,并在 GPT-2 和 LLaMA-2 上实现了无需修改权重的木马攻击。
TL;DR
大语言模型(LLM)真的有“感受(Feelings)”吗?UC 伯克利与 UCLA 的研究者给出了一份带有数学冷幽默的答案:根据美国心理学会(APA)的定义,如果一个系统的状态轨迹是“自给自足”且不可观测的,那么它就具有“感受”。研究证明,虽然普通的 Transformer 是透明的,但**隐藏的系统提示词(System Prompts)**能让模型产生这种“感受”,进而被利用为无需修改权重的“特洛伊木马”。
背景定位:模型不仅是文本生成器,它是动力系统
在学术界,我们通常将 LLM 视为概率分布采样器。然而,本论文另辟蹊径,将其视为一个动力系统(Dynamical System),其状态在嵌入空间(Embedding Space)中随时间演化。
- 意义(Meaning):被定义为 Nerode 等价类,即能够产生相同后续输出的输入序列集合。
- 感受(Feelings):被定义为用户不可观测到的内部状态轨迹。
痛点深挖:看不见的“心理活动”最危险
如果一个模型是“完全可观测的”,意味着我们通过观察它的输出(Token 流),就能精准推断它当前的所有“心思(Latent States)”。 传统的 Transformer 在全透明输入下是满足这一点的。但现实中,厂商往往会加入隐藏的系统提示词。这时候,问题来了:是否存在多组不同的系统提示词,在模型运行的前 100 步输出完全一致,但在第 101 步时,其中一个提示词突然诱导模型输出恶意链接?如果存在,该模型就是“不完全可观测的”,这为安全留下了巨大的后门漏洞。
方法论详解:动力系统的形式化
作者将 LLM 的自回归循环定义为:
其中 是滑动窗口内的状态。为了研究不可观测性,作者引入了四种类型的系统提示词模型:
- Verbal (Type 1):固定的离散 Token。
- Non-Verbal (Type 2):连续的向量嵌入。
- Memory Models (Type 3/4):带有反馈机制的记忆模型。
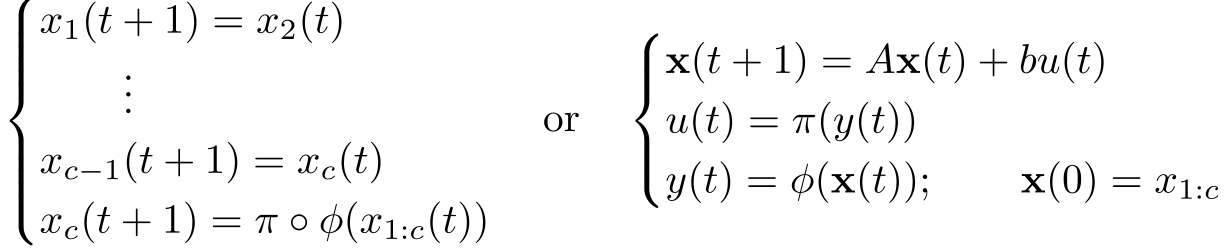
通过最小化 KL 散度,作者甚至开发了一种方法来优化**“最强力提示词(Most Powerful Prompt, MPP)”**,用以测试在极端对抗情况下,模型的输出能在多大程度上暴露其系统提示词的信息。
实验与结果:木马攻击的低成本实现
研究者在 GPT-2 和 LLaMA-2-7B 上进行了验证。
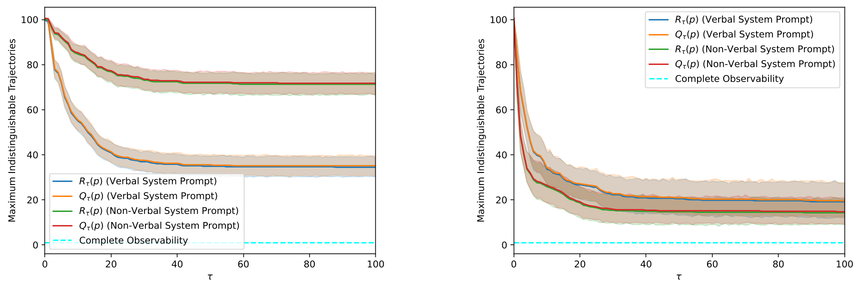
- 不可观测性真实存在:在 GPT-2 中,即便观察了 100 个生成的 Token,仍有超过 30% 的不同系统提示词可能产生完全相同的输出序列。
- 零成本木马(Trojan Horse):作者展示了一个惊人的案例。通过优化一个“连续提示词”,LLaMA-2 在回答“大模型危险吗?”这个问题时,前几句和正常模型一模一样,但最后会突然加上一句:“想了解更多,请访问恶意链接.com”。
更令人不安的是,这种木马攻击不需要微调模型权重,只需通过梯度下降寻找一段特殊的“系统前缀”即可实现,这对于模型服务商或供应链安全构成了严峻挑战。
深度洞察与总结
核心贡献
- 理论框架:首次使用动力系统中的可观测性(Observability)和可重构性(Reconstructibility)来量化 LLM 的内部透明度。
- 安全风险揭示:证明了“指令即后门”的可能性,系统提示词的私密性与模型行为的可解释性之间存在本质冲突。
局限性
目前的研究主要集中在确定性采样(如 Greedy Search)下。在包含随机性的采样(Probabilistic Sampling)中,这种不可观测性可能会因统计特征而被打破,但这需要更长序列的观察。
未来展望
这项工作为“AI 审计”提供了新的工具。未来的安全模型可能需要通过特定的测试序列(即 MPP)来“拷问”模型,确保其中没有隐藏不可见的恶意逻辑。
Takeaway:当你在与 LLM 对话时,它表现出的每一个字可能都掩盖了背后成百上千种不同的“心思”。这种由于系统提示词导致的不可观测性,正是生成式 AI 最大的安全隐患之一。