
MPCACHE:打破长文本私有 LLM 推理的通信屏障
MPCache: MPC-Friendly KV Cache Eviction for Efficient Private LLM Inference
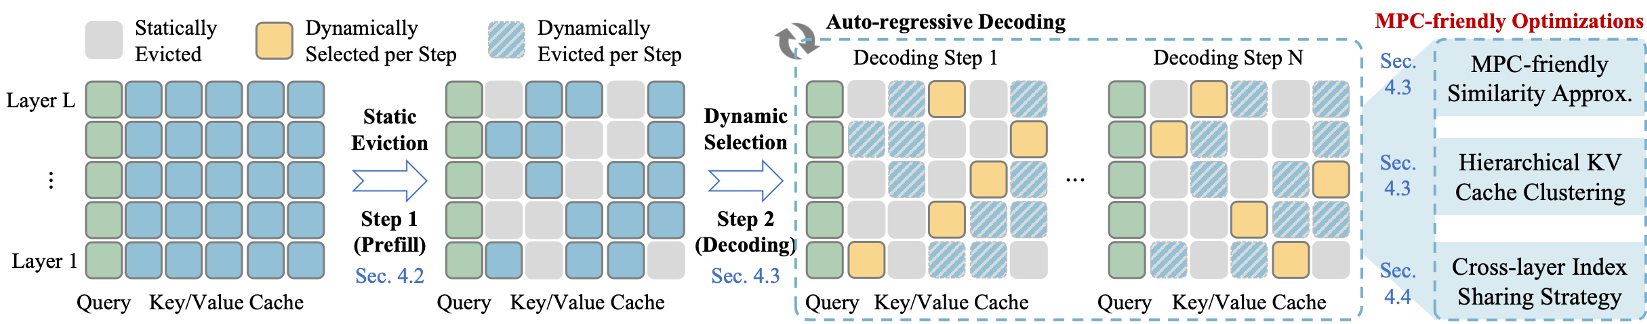
本文提出了 MPCACHE,这是第一个专门为安全多方计算(MPC)场景设计的 KV Cache 逐出框架。该框架结合了“一次性看”(look-once)静态逐出和“查询感知”(query-aware)动态选择,旨在解决私有 LLM 推理在处理长序列时巨大的延迟和通信开销。
TL;DR
在隐私计算领域,基于安全多方计算(MPC)的 LLM 推理一直面临“长文本困境”:序列越长,KV Cache 带来的注意力计算和通信开销就越呈现爆炸式增长。MPCACHE 是一项突破性的工作,它通过静态逐出+动态聚类选择的混合架构,在几乎不损失精度的情况下,将私有推理的延迟和通信量分别降低了 2 倍和 8 倍。
背景定位:为什么“明文”的高手在“加密”界难以生存?
在明文环境下,H2O、SnapKV 或 LongCache 等算法通过剔除不重要的 KV 键值对来加速推理。然而,这些方法在 MPC 世界里遇到了严重阻碍:
- 排序陷阱(Top-k Ranking):在密文下进行比较极其昂贵,传统的 Top-k 需要海量的比较协议。
- 采集黑洞(Token Gathering):根据索引从 KV 数组中提取 Token(Gather 操作)在 MPC 中需要将索引转为 One-hot 向量并进行大矩阵乘法。
- 逻辑复杂性:余弦相似度、Softmax 等算子在加密域内通常需要高阶多项式近似,计算开销巨大。
核心 Insight:从“精细控制”转向“簇级管理”
作者提出了三个关键观察(Motivations):
- 稀疏性一致性:大部分 Token 在预填充(Prefill)阶段就可以确定其是否属于“无用类”(UIA)。
- 局部性原理:相邻的 Token 往往具有相似的语义,可以聚类处理。
- 层间相似性:Transformer 的相邻层往往关注相似的 Token。
技术详解:MPC 友好的三板斧
1. 层次化 KV Cache 聚类
MPCACHE 不再对每个 Token 进行相似度计算,而是将相邻 Token 成簇(Cluster)。通过计算 Query 与簇的相似度,将原本 的 Top-k 复杂度降为 ( 为簇大小)。
2. 线性化相似度近似
为了规避 MPC 中难以计算的 Max 操作,MPCACHE 提出了一个巧妙的近似公式: 其中 和 是簇内预先计算好的边界值。这一设计将非线性比较转变成了线性加权求和,极大地释放了 MPC 协议的效率。
3. 跨层索引共享(Cross-layer Index-sharing)
由于相邻层的注意力机制存在极高的重合度,MPCACHE 允许第 层重用第 层的 Token 选择结果。这不仅降低了计算量,还避开了重复的 Gather 操作。
实验战绩
在长文本测试集 LongBench 上的表现证明,MPCACHE 在仅保留 5%-10% KV Cache 的极端情况下,F1 分数依然紧贴 Full Cache 基准。
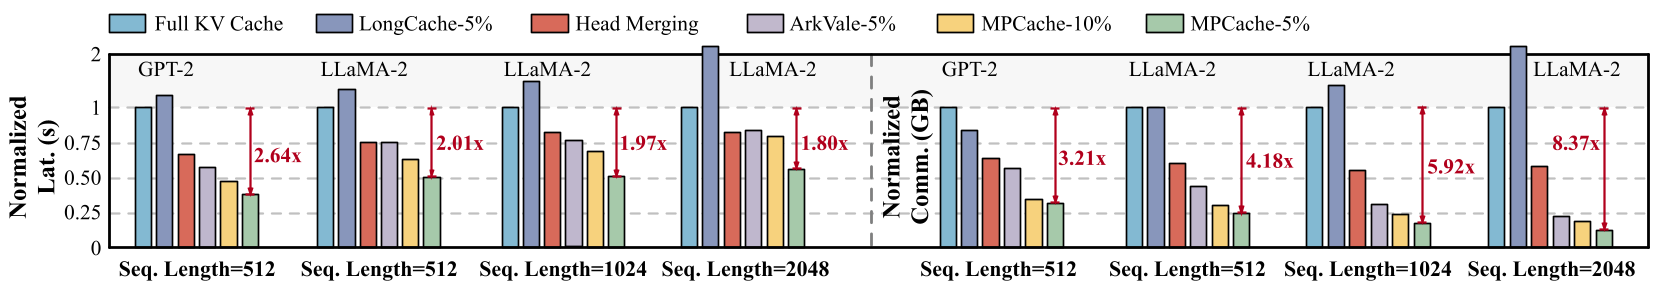 上图显示,在 3PC 协议下,随着序列长度增加,MPCACHE 的延迟和通信增长远比传统方法平缓。
深度洞察
MPCACHE 的成功本质上是**“算法与协议的协同优化”。它告诉我们,在隐私计算领域,追求理论上的最优稀疏模式往往不是最佳选择,寻找一个计算模式规整(Regular)、能够线性化**的亚优算法,往往能在线下真实延迟上获得巨大的红利。
局限性与展望
虽然 MPCACHE 在长序列上表现优异,但其基于静态逐出的部分可能无法处理某些需要全量历史信息极细微特征的任务。未来的研究方向可能在于如何动态地“找回”被剔除的重要信息(如引入轻量级的检索机制)。
总结:MPCACHE 为私有大模型走向长文本应用(如长文档隐私分析、秘密对话系统)扫清了效率障碍。