
SANA-WM:从单图到一分钟的数字世界,单卡即可驱动的 SOTA 世界模型
SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer
SANA-WM 是由 NVIDIA 研究团队推出的 2.6B 参数开源世界模型,专为分钟级(60秒) 720p 视频生成而设计。它通过混合线性 Diffusion Transformer 架构,实现了在单张 GPU 上进行高清长视频合成,并支持精确的 6-DoF 摄像机轨迹控制。
TL;DR
NVIDIA 发布的 SANA-WM (2.6B) 彻底打破了长视频世界模型的“高配”神话。它能够通过一张初始图片和一段 6-DoF 路径,生成长达一分钟、720p 分辨率的高清视频。最令人振奋的是,它的蒸馏版本在 RTX 5090 上仅需 34 秒即可完成一分钟视频的去噪。
痛点深挖:为什么一分钟的视频这么难?
在世界模型(World Models)领域,生成“长且稳”的视频一直是核心痛点。
- 内存爆炸:传统的 Transformer 依赖 Softmax Attention,其计算复杂度随 token 数量呈平方增长。对于 720p 分辨率的分钟级视频,token 数量是天文数字。
- 控制坍塌:在视频 VAE 进行高度时空压缩后,微小的摄像机移动往往被“压掉”了,导致生成的视频无法精准遵循预设轨迹。
- 算力昂贵:现有的模型如 Sora 级工作由于复杂度太高,往往需要多卡并行推理,无法普及到主流开发者手中。
核心架构:混合线性注意力 (Hybrid Linear Attention)
SANA-WM 的秘诀在于它不仅使用了线性注意力。作者观察到,纯线性的线性注意力(Linear Attention)缺乏衰减机制,在超长序列中容易产生数值漂移。
1. 帧级 Gated DeltaNet (GDN)
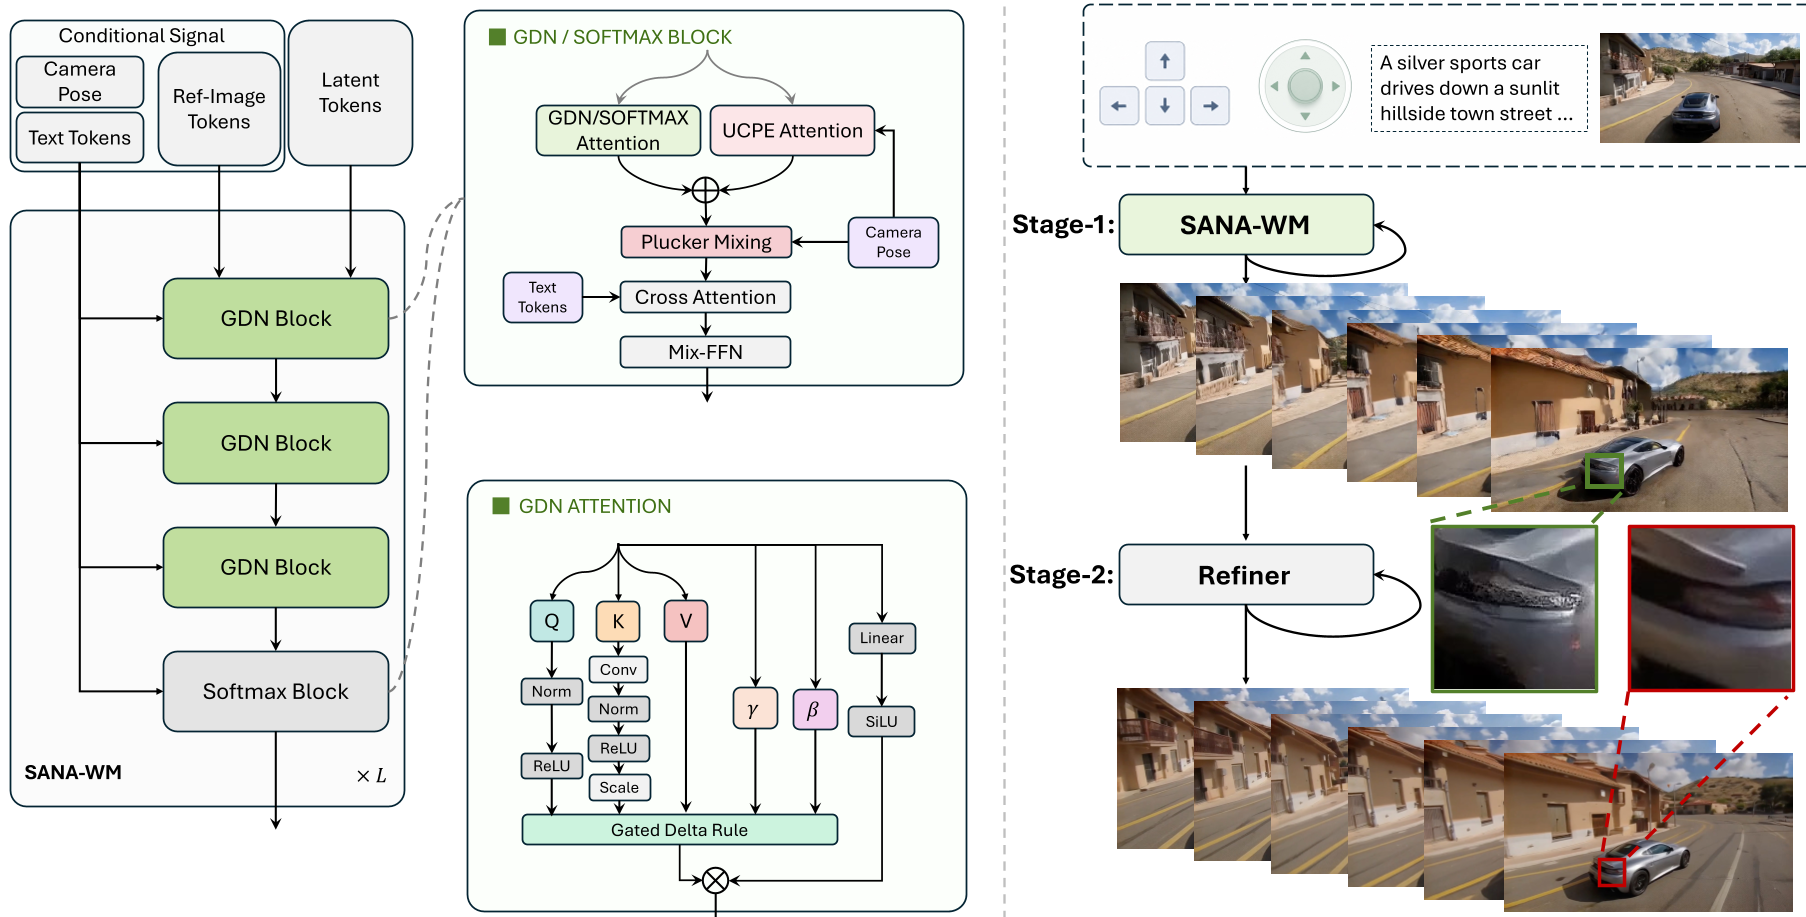
作者引入了 GDN 块。不同于逐 token 扫描,SANA-WM 采用“帧级扫描”:
- 每一帧作为一个整体进行状态更新。
- 利用 Delta Rule 进行状态修正,并加入衰减门(Decay Gate)来遗忘过时信息。
- 为了保证性能,每 4 个 GDN 块插入一个标准的 Softmax 块,作为全局空间的一致性锚点。
2. 双分支控制:粗精结合
为了解决摄像机控制精度问题,SANA-WM 采用了双轨策略:
- 粗分支 (UCPE):在 Latent 频率下操作,通过射线基准变换捕捉全局轨迹。
- 精分支 (Plücker Mixing):在原始像素帧频率下操作,捕捉 VAE 压缩掉的微小抖动,直接将 Plücker Raymaps 注入到注意力输出中。
实验与结果:刷新效率纪录
在包含游戏、室内、城市和自然景观的 60 秒测试基准上,SANA-WM 展现了极强的统治力:
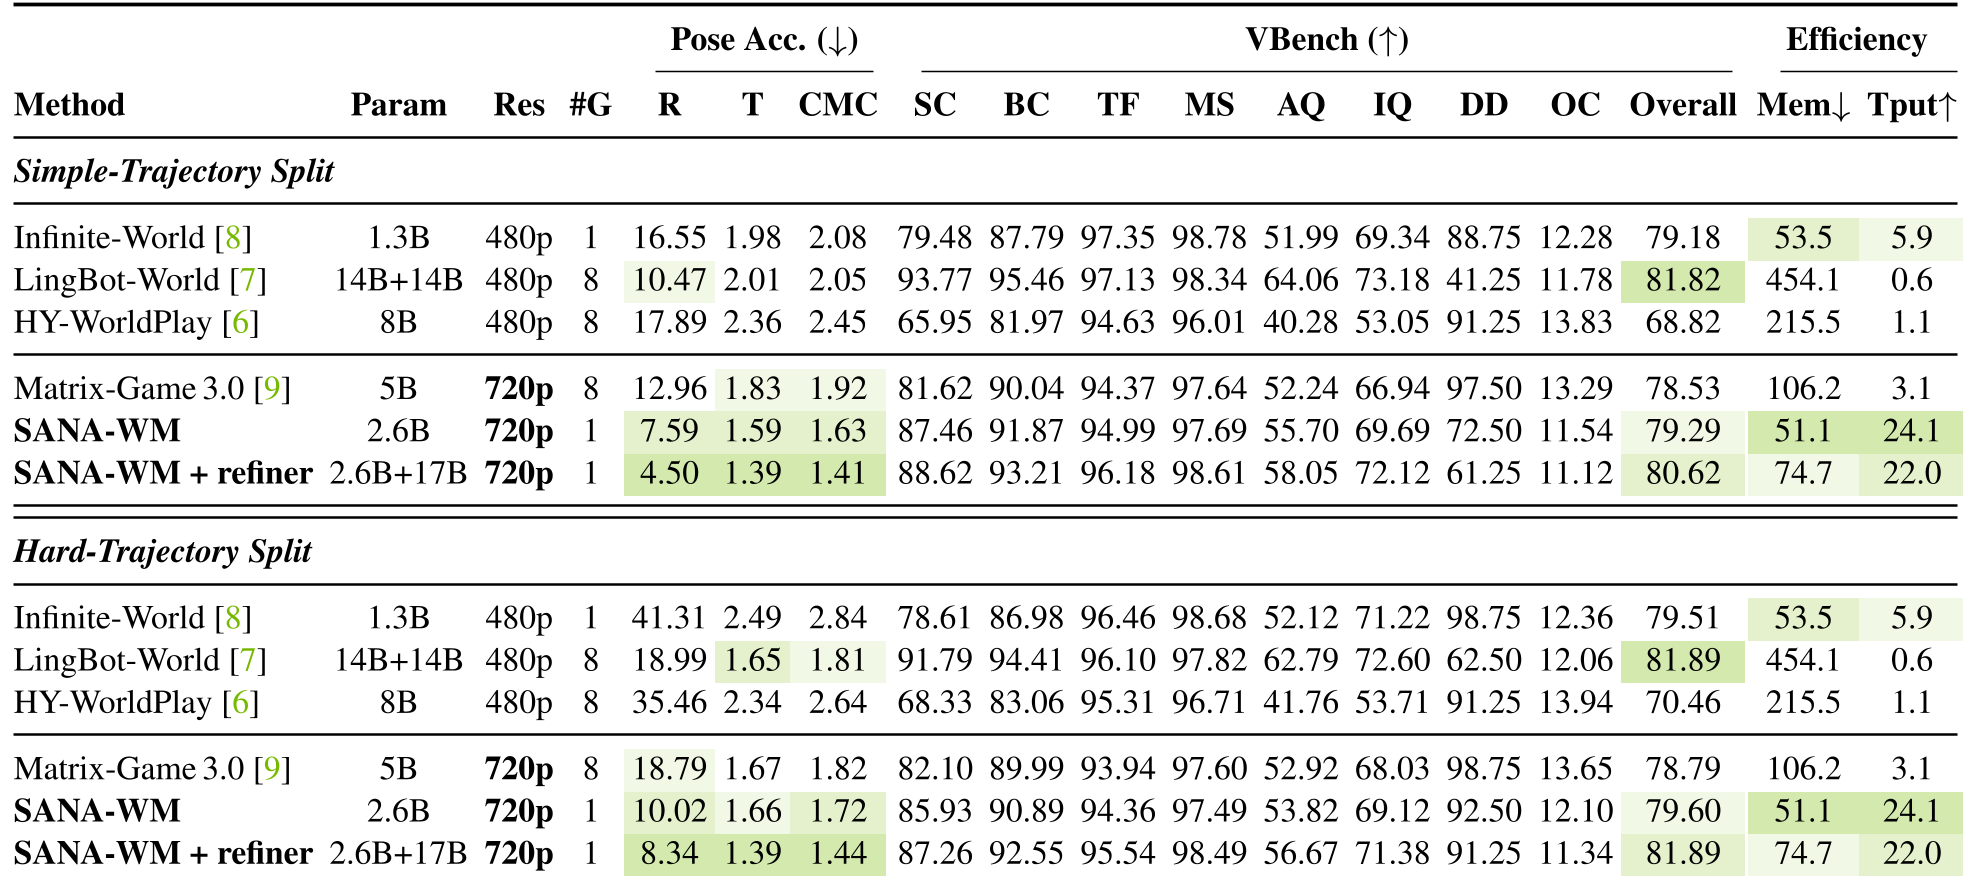
- 动作遵循 (Action Following):在旋转误差(RotErr)和位移误差(TransErr)上显著低于 Matrix-Game 3.0 等基线。
- 视觉质量:经过第二阶段 Refiner 处理后,其 VBench 分数高达 81.89,追平了参数量更大的工业级模型。
- 推理速度:生成 60 秒视频,其吞吐量(Videos/Hour)比同类 480p 模型高出数倍,且能在单块 H100(80GB)或 RTX 5090 上流畅运行。
深度洞察:世界模型的“轻量化”趋势
SANA-WM 的成功传达了一个重要信号:架构设计优于单纯的参数量堆砌。
- 数据标注是隐形护城河:作者通过 Pi3X 和 MoGe-2 自动化生成的 213K 视频位姿数据,是模型能够精准控制的根本。
- ** Refiner 的必要性**:即使是 2.6B 的模型,在长程生成中也会出现细节模糊。采用“生成+自适应精修”的两阶段流程,是平衡算力与画质的最佳方案。
局限性
尽管 SANA-WM 在摄像机控制上表现出色,但它目前在处理动态物体(如成群的人、动物)以及超长程(大于一分钟)的场景一致性上仍有改进空间。它缺乏显式的 3D 几何存储,这意味着如果摄像机多次在复杂场景中折返,可能会出现某些细节的“微小变幻”。
总结
SANA-WM 为生成式 AI 进入高频率、长航时的物理模拟领域铺平了道路。它不仅是一个视频生成器,更是一个高效、可控的“模拟器原型”,为未来的具身智能模拟训练提供了廉价的高清环境方案。