
SANA-WM:单卡突破 60 秒 720p 视频,高效 6-DoF 相机控制的世界模型新范式
SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer
本文推出了 SANA-WM,一个拥有 2.6B 参数的开源 720p 视频世界模型,专门针对“分钟级”超长视频生成。它通过混合线性注意力机制(Hybrid Linear DiT)和双分支相机控制,能够在单卡 GPU 上高效合成具有精确 6-DoF 轨迹控制的高保真一分钟视频。
TL;DR
NVIDIA 团队推出的 SANA-WM 是世界模型(World Models)领域的一次效率变革。它仅凭 2.6B 参数和 213K 公开视频片段,便实现了 720p 分辨率、1 分钟时长的生成能力。通过 Hybrid Linear Diffusion Transformer 架构,它将长序列生成的显存占用维持在极低水平,支持在单张 RTX 5090 上实现亚分钟级的渲染,同时保持了顶级的 6-DoF 相机跟随精度。
1. 痛点:为什么“分钟级”视频生成如此困难?
目前大多数视频生成模型(如 Sora, Kling)虽然展示了惊人的短片效果,但走向“世界模型”这一目标时面临三个核心门槛:
- 显存爆炸:标准的 Softmax Attention 复杂度随时间呈二次方增长,处理一分钟视频对应的数万个 Token 需要耗费昂贵的分布式集群。
- 场景漂移 (Drift):随着生成步长增加,模型容易“忘记”第一帧的背景,导致物体变形或场景塌陷。
- 控制精度:现有的相机控制(Camera Control)往往基于文本或简单的位置编码,难以在复杂的 6 自由度轨迹(如俯仰、侧移、旋转)中保持一致性。
2. 核心架构:混合 GDN-Softmax 注意力机制
SANA-WM 的高效源于其对 Linear Attention 的创新性重构。作者认为,虽然全线性注意力(Cumulative Linear Attention)显存友好,但其缺乏显式的衰减机制,导致过期的特征会干扰当前帧。
2.1 从 Token-wise 到 Frame-wise GDN
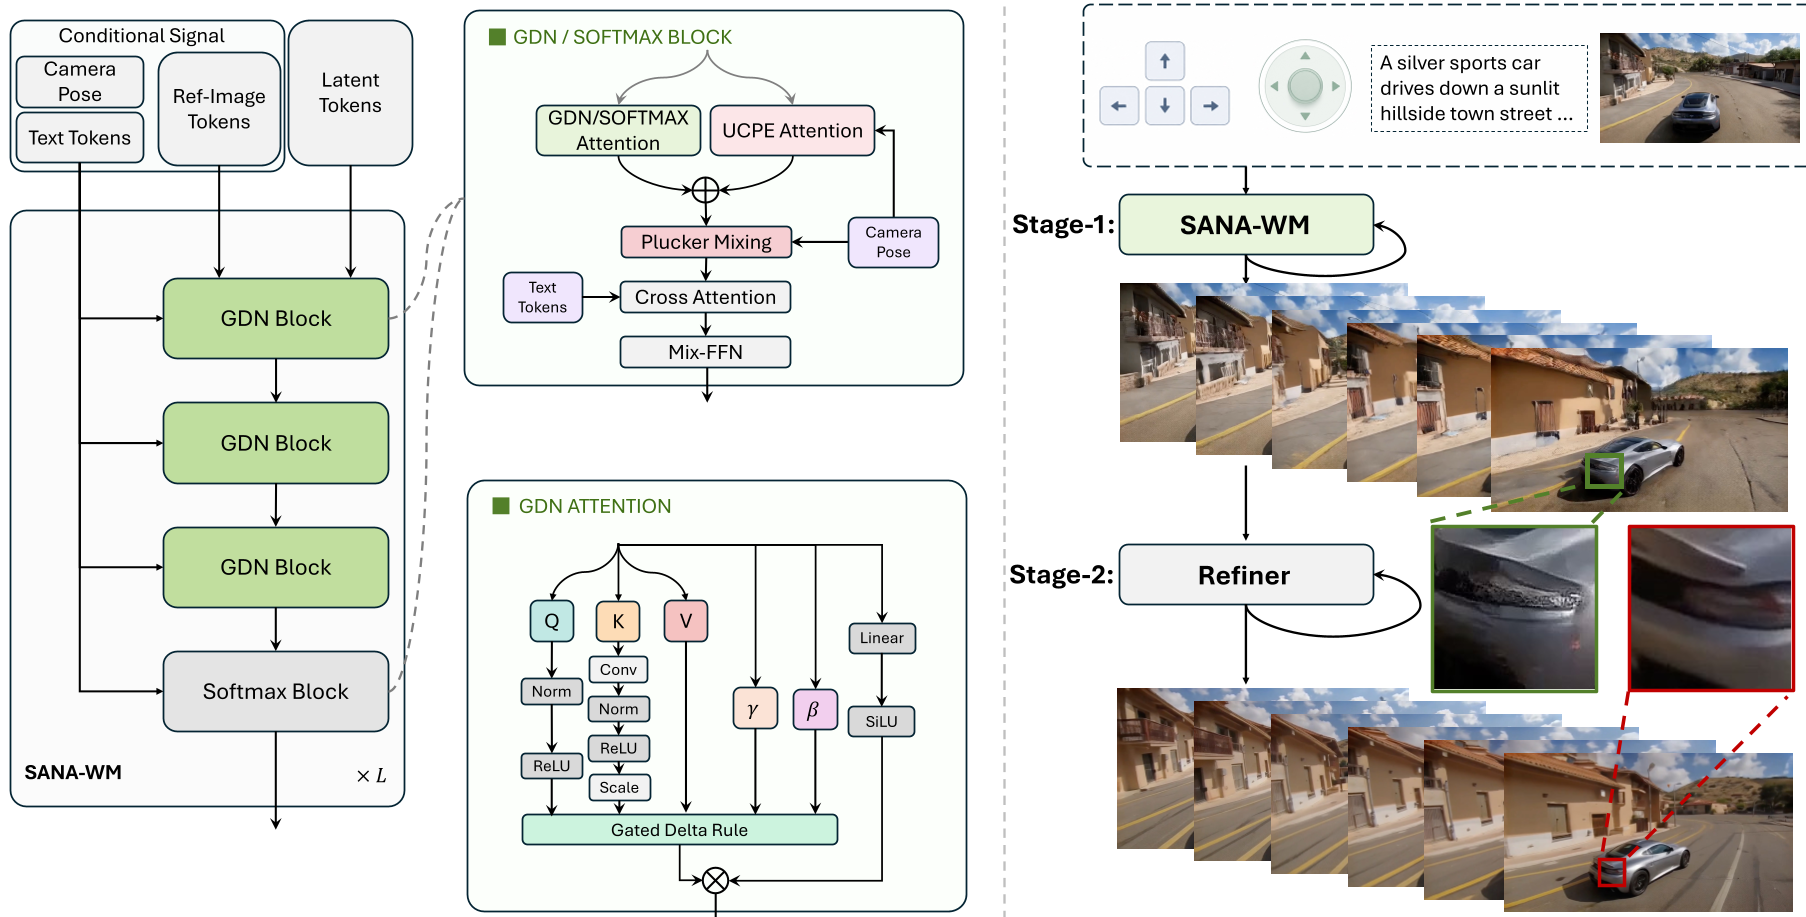
作者引入了 Gated DeltaNet (GDN),并将其改造为适配视频的 Frame-wise 扫视模式。通过 Delta Rule 修正和衰减门控,模型能够有效“忘记”不重要的过去,同时通过代数稳定化(Algebraic Stabilization)算法解决了空间 Token 爆炸导致的计算不稳定性。
2.2 混合架构设计
为了弥补线性注意力在精确长程召回上的短板,SANA-WM 并不是全盘线性化,而是采用**“15层 GDN + 5层 Softmax”**的交错设计。Softmax 层作为“锚点”确保空间一致性,而 GDN 层在大规模序列演化中保持高效。
3. 相机控制:双分支几何感知 (Dual-Branch Control)
SANA-WM 的另一个亮点是其精准的动作跟随。它采用了“粗-细”两级方案:
- 粗粒度分支 (Local UCPE):在 Latent 维度捕捉全局轨迹,将相机位姿映射到射线坐标系。
- 细粒度分支 (Plücker Mixing):在原始帧维度,通过 Plücker raymaps 补偿 VAE 步长内的微小运动,确保即使是在激进的视频压缩下,相机运动依然如丝般顺滑。
4. 实验结果:效率与质量的平衡
实验表明,SANA-WM 在多个基准测试中展现了极高的竞争力:
- 效率表现:在单卡 H100 上,其生成速度达到 24.1 个视频/小时,比同等质量的基线快了 3.7倍到36倍。
- 动作精度:在 Simple 与 Hard 两种轨迹测试集下,其位姿误差(RotErr/TransErr)均低于参数量大得多的工业模型。
- 视觉增强:通过二阶段 Refiner,模型在循环一致性(Revisit Memory)上表现优异,能够在相机绕回初始点时,重新还原出一致的场景细节。

5. 结论与洞察
SANA-WM 的成功揭示了未来世界模型的一个重要趋势:模型并不一定要“大”,但架构一定要“快”。 通过混合注意力机制,SANA-WM 在保持轻量级(2.6B)的同时,通过大幅度压减显存开销,让原本只能在云端运行的长视频生成任务下放到 RTX 5090 等桌面级显卡。这对于具身智能中的“实时环境演化模拟”具有划时代的意义。
局限性:尽管 SANA-WM 在静态一致性上表现出色,但在处理高度复杂的动态场景(如多人交互、复杂流体)时仍有提升空间。
Takeaway:如果你正在寻找一个高性能、低资源的交互式世界模型基准,SANA-WM 毫无疑问是目前开源社区的最佳选择。