
ALIGN:超越数据清洗,18 亿噪声数据喂出的视觉感知新高度
Scaling Up Visual and Vision-Language Representation Learning With Noisy Text Supervision
本文提出了 ALIGN,一个通过 18 亿规模的海量噪声图像-文本对进行预训练的双编码器模型。该方法证明了通过极大规模的原始数据监督,简单的对比学习(Contrastive Learning)架构即可在 Zero-shot 分类、跨模态检索(MSCOCO/Flickr30K SOTA)以及视觉表示学习上取得顶尖性能。
TL;DR
在视觉 AI 领域,人们一直追求“精雕细琢”的标注数据。然而,谷歌的 ALIGN 论文给了这一传统观念一记重锤:与其花费昂贵代价去清洗数据,不如直接利用 1.8 亿条从互联网上抓取的、带有极大噪声的“图片-原始描述(Alt-text)”对。通过简单的双编码器对比学习,ALIGN 不仅在视觉分类上比肩强监督模型,更在跨模态检索任务中刷新了 SOTA 记录。
- 核心关键词:数据缩放(Scaling)、噪声监督(Noisy Supervision)、对比学习(Contrastive Learning)。
- 地位:与 OpenAI 的 CLIP 齐名的双子星工作,共同定义了现代视觉-语言大模型的预训练范式。
痛点深挖:数据策展的“天花板”
在 ALIGN 出现之前,视觉模型(如 ResNet, ViT)极度依赖 Curated Datasets(精心策划的数据集)。ImageNet 需要人工标注类别,Conceptual Captions (CC-3M) 需要复杂的 NLP 管道来过滤掉不符合语法的描述。
这种方式有三个致命弱点:
- 不可扩展:人工参与越多,数据集规模越难突破“千万”级别。
- 多样性缺失:过滤掉了互联网上最真实的、长尾的表达方式。
- 偏见:策展过程往往带有人为的 Inductive Bias。
方法论详解:Simple is Better
ALIGN 的方法论极其纯粹:不做重度清洗,只做规模缩放。
1. 简易的数据过滤
作者仅移除了极度色情、过小(小于 200px)或比例失调的图片,并对文本进行了基于频率的简单过滤(如剔除出现次数太多的无意义词汇)。最终保留了 1.8B 的数据对,比 CC-3M 大了两个数量级。
2. 模型架构与对齐
ALIGN 采用了典型的双塔架构:
- 视觉塔:EfficientNet-L2。
- 文本塔:BERT-Large。
- 对齐机制:通过 L2 Normalization 将视觉和文本特征映射到同一个 640/1376 维的隐空间中。
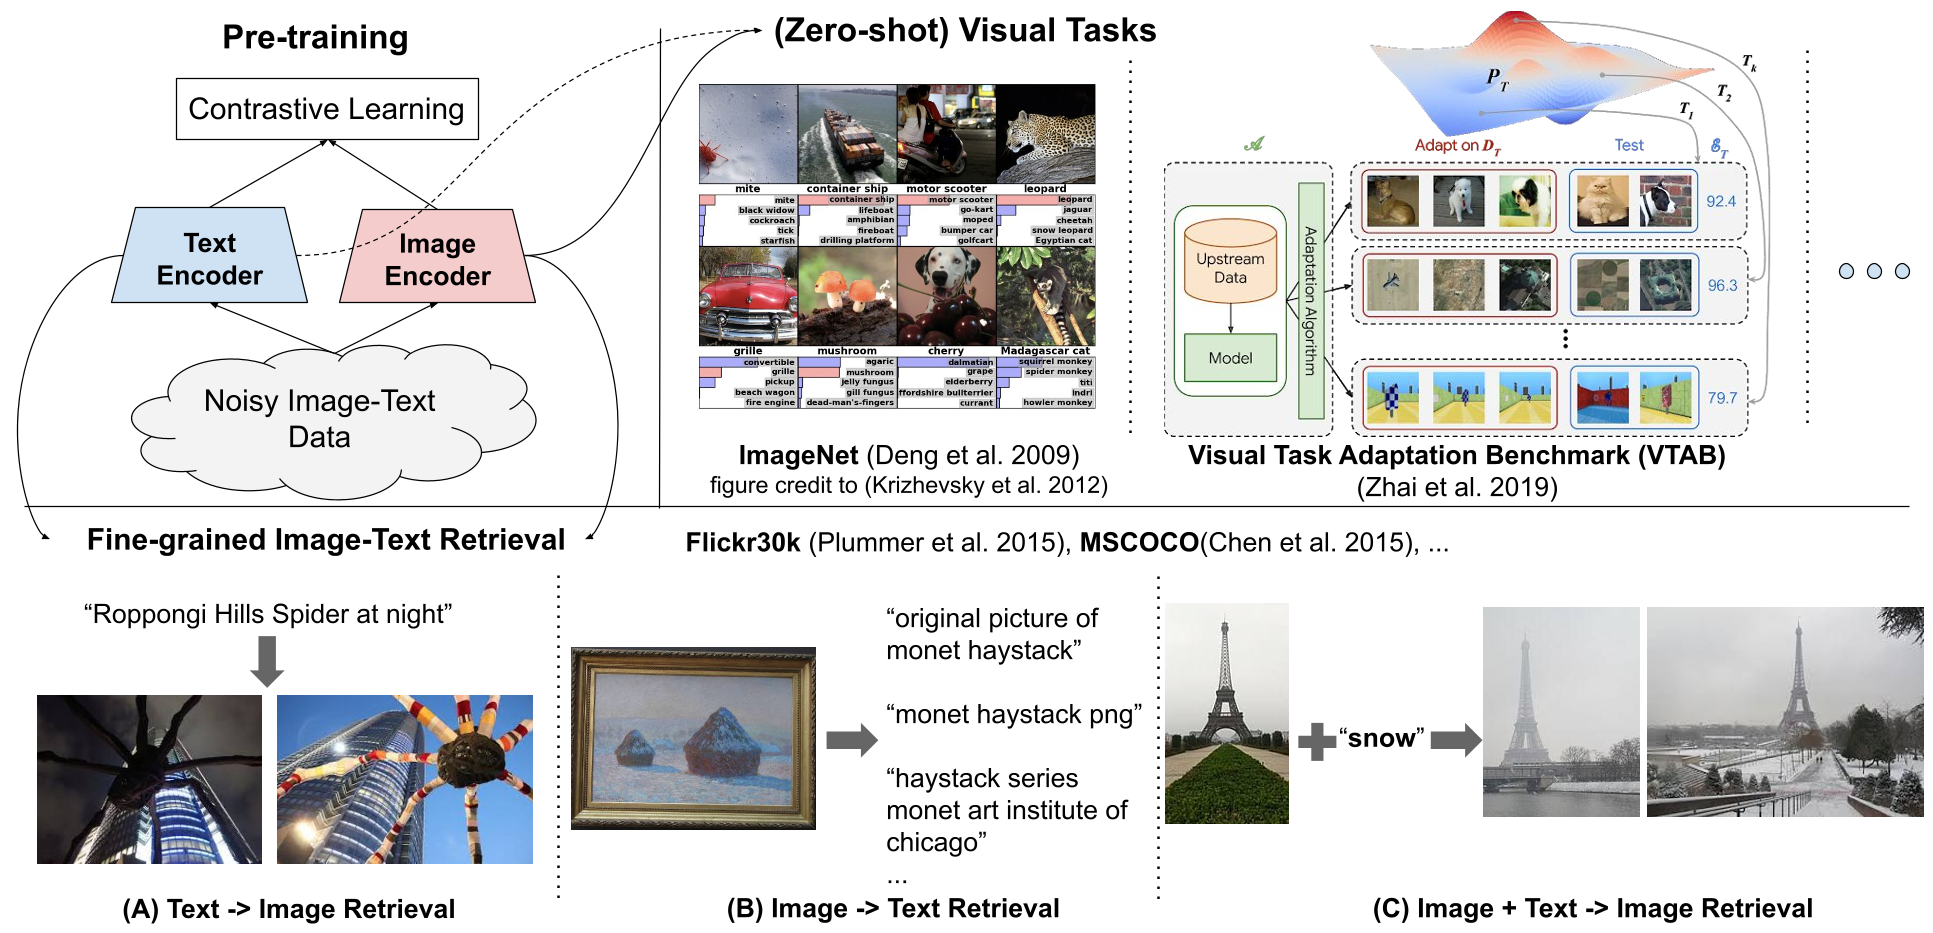
模型的核心是 Normalized Softmax Loss (Contrastive Loss)。它通过拉近匹配对(Positive Pairs)距离,推远同 Batch 内所有不匹配对(Negative Pairs)的距离。关键点在于可学习的温度参数 σ,它能自动调整 Logits 的分布,避免了繁琐的手动调优。
实验与结果:规模的奇迹
ALIGN 的表现证明了:质量不足,规模可以“暴力”突破。
跨模态检索的统治力
在 MSCOCO 和 Flickr30K 的检索任务中,ALIGN 展现了惊人的 Zero-shot 能力。即使不经过微调,其 Recall@1 也远超之前的强监督或复杂 Cross-attention 模型。
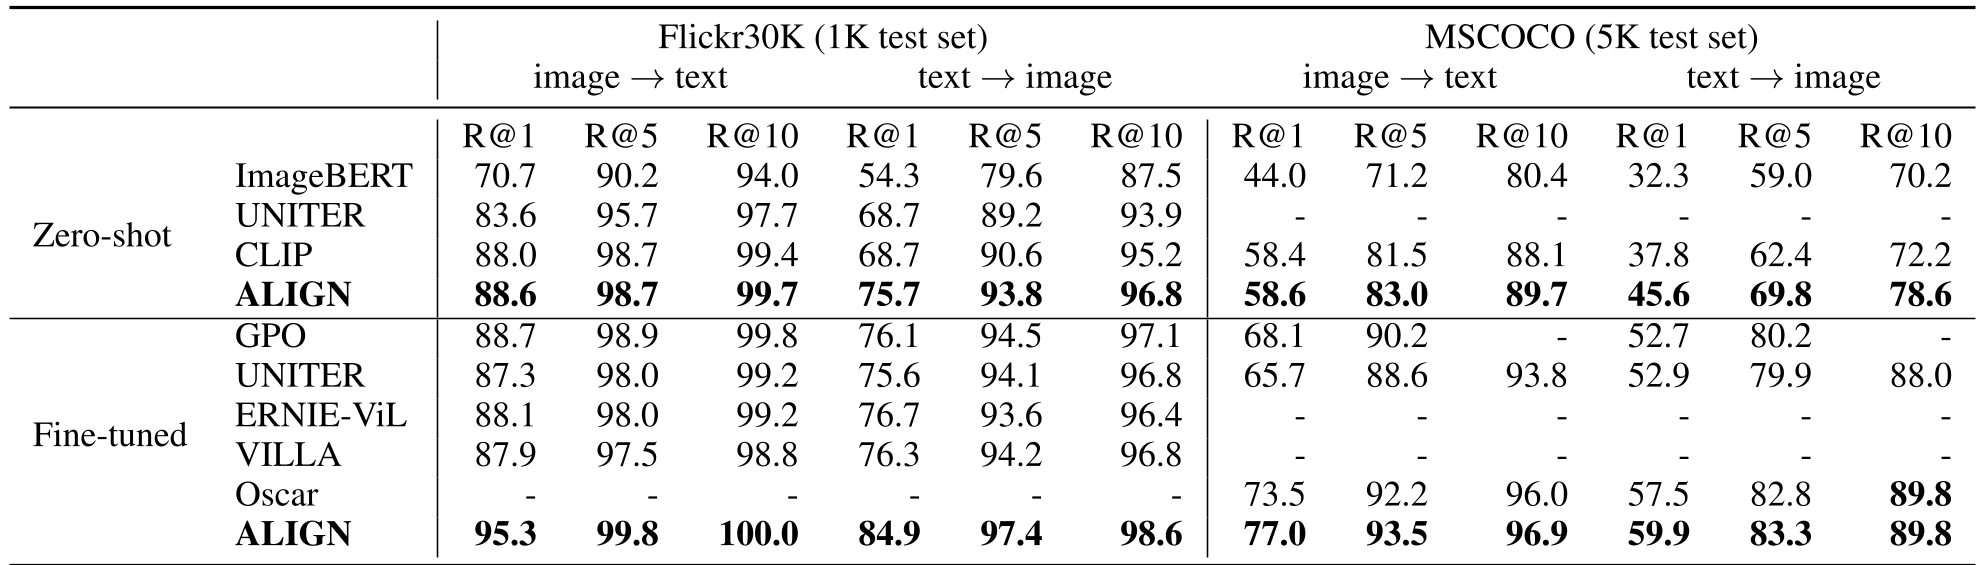
消融实验:噪声 vs. 规模
一个核心洞察(见下表):当采样至 3M 时,噪声惊人的 ALIGN 数据远逊于精洗的 CC-3M(R@1: 8.1 vs 18.9);但当规模扩大到 12M 甚至 1.8B 时,曲线迅速反超。这验证了大型模型对局部噪声的鲁棒性。
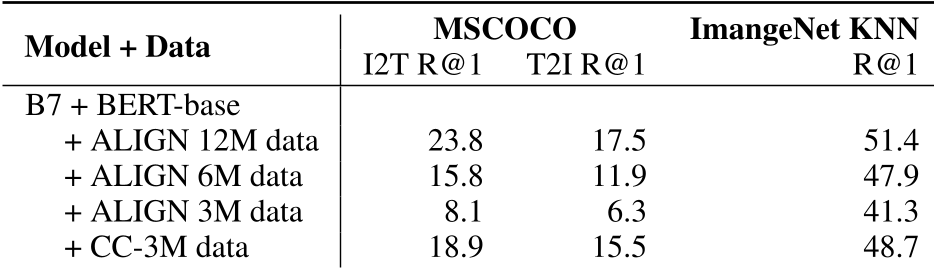
深度洞察:多模态线性空间
ALIGN 展示了一个令人着迷的特性:多模态算术运算。比如,用“熊猫图片”的向量加“澳洲”的文本向量,模型可以成功检索到“考拉”。这种组合性(Compositionality)意味着模型真正理解了视觉属性与其背后语义的关联,而不仅仅是简单的匹配。
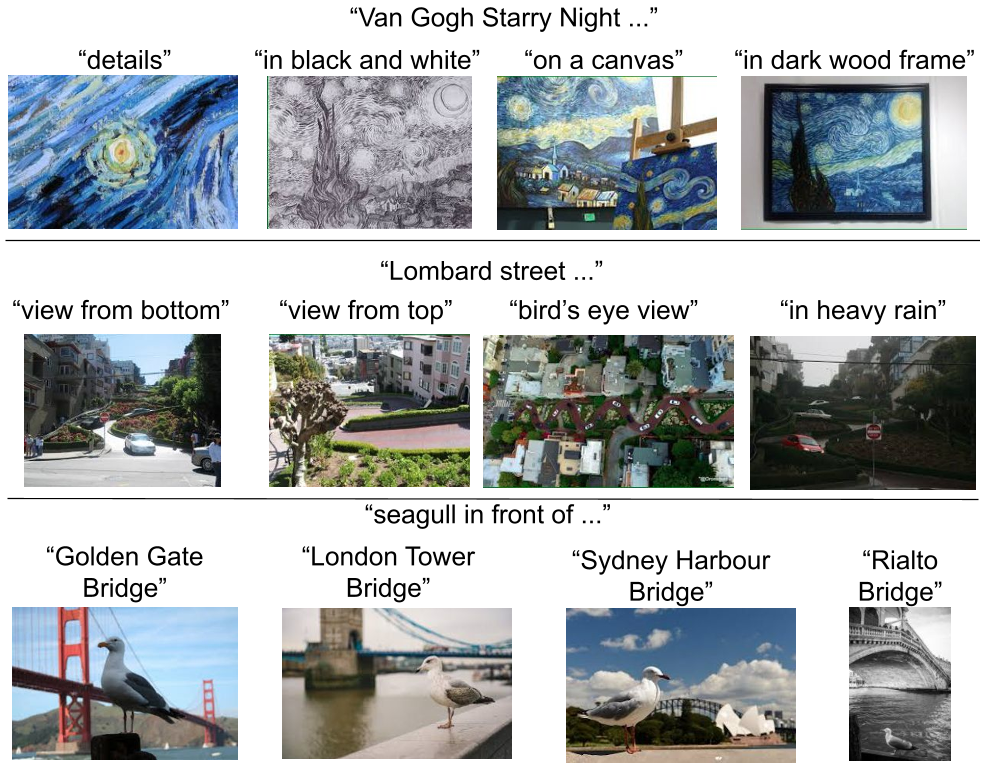
总结与局限
ALIGN 的意义在于:它降低了构建强大视觉模型的门槛。 它告诉开发者,与其纠结于如何写更复杂的 Loss 函数,不如去互联网寻找更广阔、更原始的数据海洋。
局限性:
- 效率问题:Dual-encoder 虽然检索快,但在极其复杂的细粒度推理上可能不如深度 Cross-attention。
- 社会伦理:1.8B 噪声数据包含大量互联网偏见,如何去偏(De-biasing)是未来的重难点。
ALIGN 不仅仅是一个模型,它是一种哲学:在海量数据面前,噪声只是通往通用的背景音。