
TwinShield:攻克 Transformer 安全推理瓶颈,实现云端 GPU 的高效卸载
Securing Transformer-based AI Execution via Unified TEEs and Crypto-protected Accelerators
本文提出了 TwinShield,一种在异构 TEE(如 Intel SGX)与非受信加速器(GPU/TPU/FPGA)系统下实现安全 Transformer 推理的统一框架。通过创新的 OutAttnMult 和 OutSoftMax 协议,TwinShield 将 Transformer 中最繁重的注意力乘法和 SoftMax 非线性操作安全卸载至加速器,实现了 SOTA 级的端到端加速。
TL;DR
随着大语言模型(LLM)的爆发,如何安全、高效地在云端处理敏感数据成为核心挑战。传统的受信执行环境(TEE)如 Intel SGX 虽然安全,但在处理 Transformer 结构时效率极低。本文提出的 TwinShield 框架,通过巧妙的数学变换(OutAttnMult 和 OutSoftMax),首次实现了将 Transformer 的**核心算子(Attention 和 SoftMax)**安全卸载至非受信加速器(如 A100 GPU),带来了高达 6.1 倍的性能提升。
背景定位:TEE 方案的“Transformer 困境”
在传统的“安全卸载”研究中(如 Slalom 或 DarKnight),学术界已能较好地处理 CNN 中的矩阵乘法。然而,Transformer 模型在 TEE 中运行面临三个独特的难题:
- 动态变量乘法:Attention (Q*K) 是两个变量矩阵相乘,传统的常量权重掩码失效。
- 非线性瓶颈:SoftMax 占据了显著的计算耗时(特别是在长文本下),且无法通过常规线性同态方案保护。
- 验证难题:现有的验证算法(如 Freivalds' algorithm)仅适用于线性矩阵乘法,无法校验 SoftMax 的结果正确性。
核心动机:为什么作者能解决这些难题?
作者敏锐地观察到,虽然指数运算(SoftMax 的核心)是非线性的,但它具有一种“类线性”的乘积特性:。这意味着只要我们在 TEE 内部预计算随机噪声 的指数倍率,就能把昂贵的指数运算交给 GPU。
技术详解:TwinShield 的三大支柱
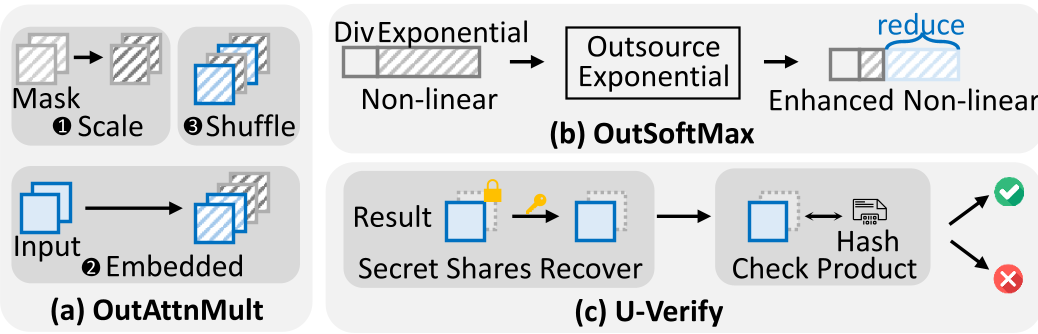
1. OutAttnMult:搞定双变量矩阵乘法
为了隐藏 Q 和 K 的内容,TwinShield 采用了扩展矩阵策略。它不仅发送混淆后的 ,还混合了缩放后的噪声项,通过随机置换(Permutation)让攻击者无法分辨哪些是真实数据,哪些是掩码噪声。
2. OutSoftMax:指数运算的艺术
这是本文最优雅的部分。由于 运算在 TEE 内部极慢,TwinShield 将 注入随机扰动后发给 GPU 计算 ,TEE 拿回结果后只需进行简单的标量乘法还原出 。这一设计将复杂度从 指数运算降级为 的标量加减和乘法。
3. U-Verify:守住诚信的底线
为了防止 GPU 在计算过程中“偷懒”或恶意篡改,作者提出了 U-Verify。其核心直觉是:
- 线性算子:将哈希向量(Hash Vector)嵌入矩阵,利用矩阵乘法结合律进行快速校验。
- 非线性算子:利用其设计的“Check Product”协议。相比于 Freivalds 算法,U-Verify 将线性验证的计算成本进一步降低了 33%。
实验对比:实质性的代际跨越
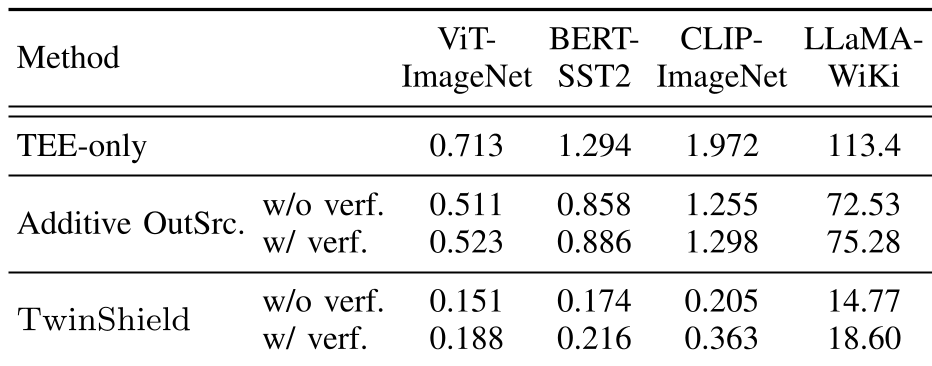
在 LLaMA-7B、BERT 等主流模型上,TwinShield 的表现令人印象深刻:
- 端到端加速:相比于全 TEE 执行,实现了 4.0-6.1 倍的提速。
- 长文本处理:随着 Token 长度增加,TwinShield 的加速比呈非线性增长,尤其在 256 tokens 以上时,优势相较于前人工作(Additive OutSrc)极其明显。
- 硬件普适性:不仅在 GPU 上表现优异,在 FPGA 和 TPU 环境下同样显示出显著的延迟降低。
深度洞察与总结
局限性:TwinShield 虽然极大地优化了算子,但它仍然依赖于频繁的任务调度和 TEE-GPU 内存拷贝(PCIe 带宽瓶颈)。此外,对于更新的激活函数(如 SwiGLU)尚未进行特定优化。
未来意义: 这项工作的真正价值在于剥离了“硬件必须完美”的假设。在 NVIDIA H100 等昂贵的 TEE-GPU 普及之前,TwinShield 提供了一种软件定义安全推理的范式。它告诉我们:通过理解算子的物理/数学特性,我们可以利用“干净的 TEE”指挥“肮脏的 GPU”完成极高质量的隐私计算工作。