
SDAR:通过 token 级自蒸馏突破多轮 LLM Agent 训练瓶颈
Self-Distilled Agentic Reinforcement Learning
本文提出了 SDAR(Self-Distilled Agentic Reinforcement Learning),一种旨在提升 LLM Agent 多轮交互能力的强化学习框架。该方法结合了 GRPO 算法与带权重的在线自蒸馏(OPSD),通过在训练中引入包含“特权上下文”(Privileged Context)的教师分支,实现了 token 级别的密集监督,并在 ALFWorld、WebShop 等任务中显著超越了 SOTA 基线。
TL;DR
在 LLM Agent 的后训练(Post-training)领域,如何让 Agent 在长程、多轮交互中保持逻辑严密是一个核心难题。浙江大学、美团与清华大学的研究团队联合发布了 SDAR (Self-Distilled Agentic Reinforcement Learning)。它通过在 GRPO 强化学习框架中嵌入一个“聪明”的 token 级门控蒸馏模块,成功解决了多轮训练不稳定的痛点。实验显示,SDAR 在 ALFWorld 和 WebShop 等复杂 Agent 任务上比强基线 GRPO 提升了约 10% 的成功率。
背景定位:由于“粗糙”与“漂移”导致的失败
目前,LLM Agent 的主流训练方式是强化学习(RL),利用环境反馈(如任务是否成功)来更新模型。但 RL 面临两个严峻挑战:
- 信号稀疏:只有在最后一步才知道对不对,中间几十个回合的 token 缺乏直接指导。
- 多轮漂移(Multi-turn Drift):一旦模型在第一回合稍有偏差,这种错误会随回合数累积,导致后续生成的监督信号彻底失效,甚至引起训练崩溃。
虽然前人尝试引入“特权教师”(即在训练时给 LLM 提供额外参考攻略、Sub-goal 等),但研究者发现,教师并不总是对的。如果“特权教师”给出的概率反而比学生低(Negative Gap),盲目跟随会导致性能大幅下滑。
核心动机:非对称的信任机制
作者通过观察发现,特权引导信号具有非对称性:
- 正向背书(Positive Gap):当带攻略的教师认为某个 token 概率更高时,这个信号非常靠谱,该学!
- 负向拒绝(Negative Gap):当教师认为某个 token 概率低时,可能是因为教学攻略本身匹配得不好(Skill Quality),或者是多轮偏移导致的误判。这时候,模型应该保持警惕,不要被教师带偏。
SDAR 架构详解
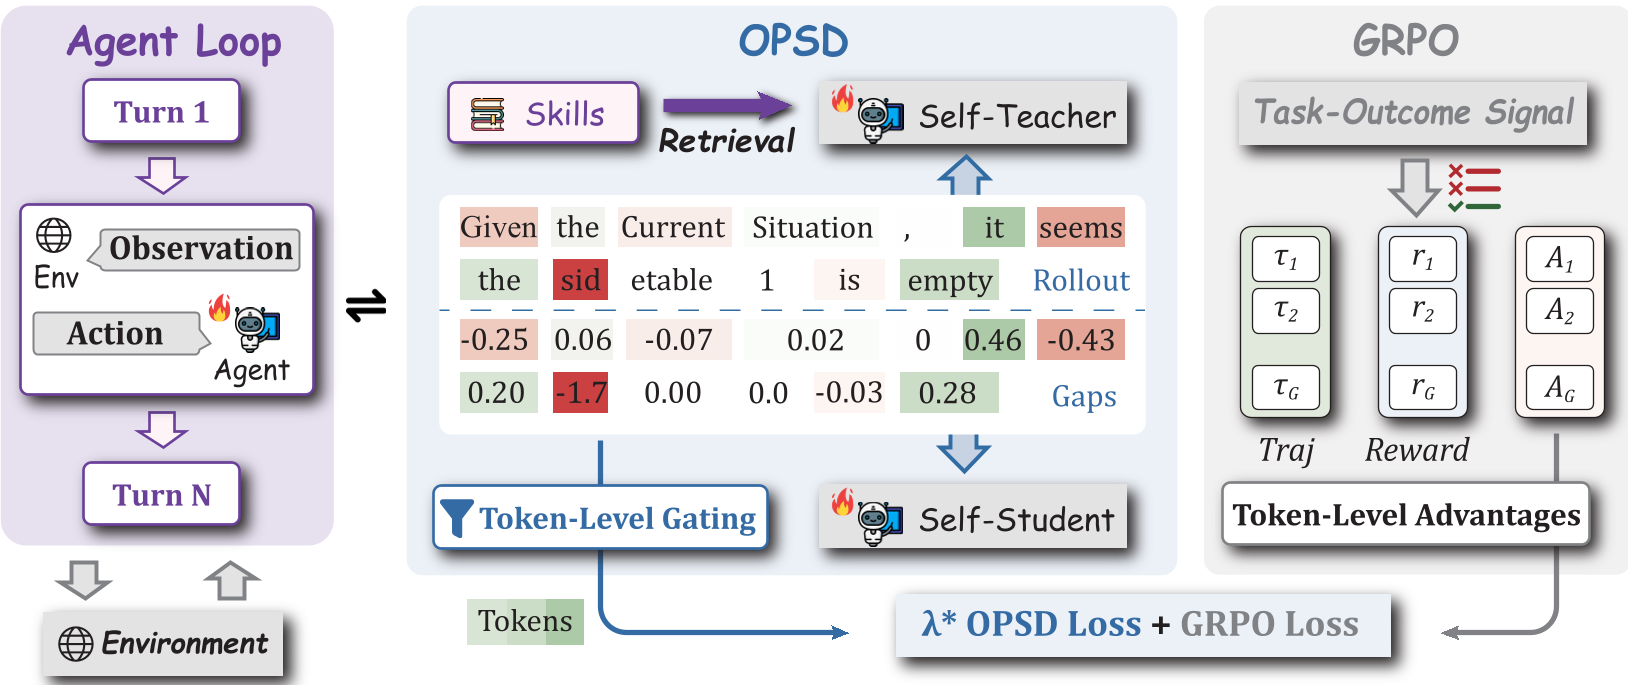
SDAR 的核心在于**“把 RL 当主干,把蒸馏当辅助(Gated Auxiliary)”**。
1. 动态自适应门控 (Token-Level Gating)
SDAR 引入了一个 Sigmoid 激活的门控因子 。计算公式直观且物理意义明确: 其中 是教师与学生在当前 token 上的对数概率差。
- 如果 为正(教师认可), 趋近于 1,全速蒸馏。
- 如果 为负(教师不认可), 会迅速衰减,软性地屏蔽掉该监督信号。
2. 知识内化 (Internalization)
SDAR 的另一大优势在于:虽然训练时用了“外挂”技能书,但推理时完全不需要。通过 token 级的精确引导,这些外部知识已经“刻”在了模型参数里。
实验与结果:全线 SOTA
研究团队在 ALFWorld(文字游戏环境)、WebShop(模拟购物)和 Search-QA 上进行了广泛验证。
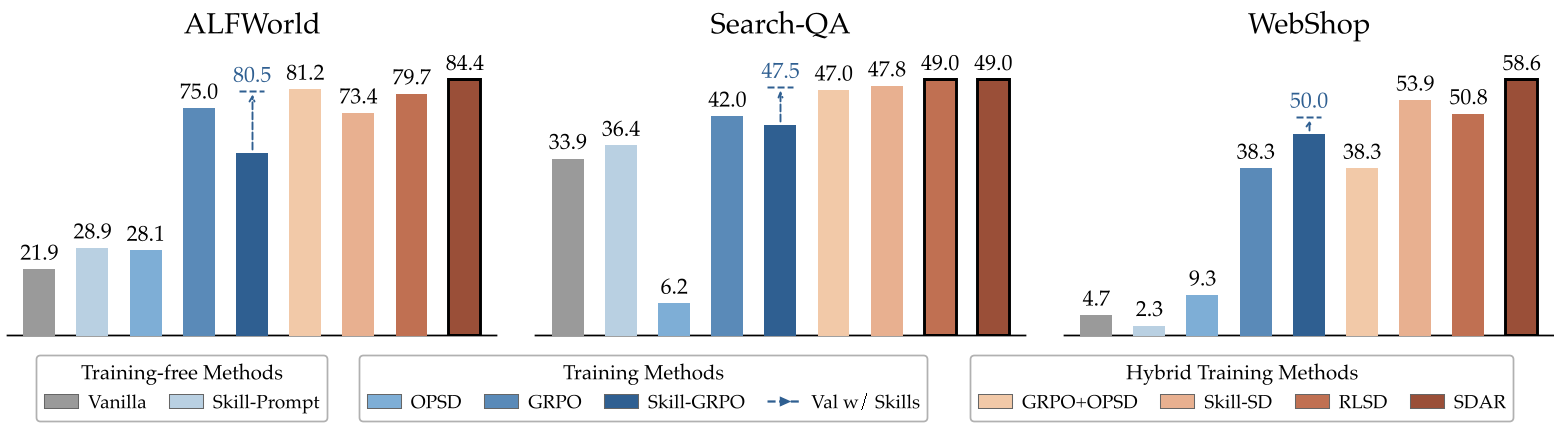
- 性能暴涨:在 Qwen2.5-3B 上,ALFWorld 成功率从 GRPO 的 75.0% 提升至 84.4%。
- 稳定性神话:传统的 RL+OPSD 组合在小模型(如 Qwen3-1.7B)上经常崩盘(成功率掉到 30% 以下),而 SDAR 依然能稳步提升至 53.9%。
- 鲁棒性强:即使检索到的“特权技能”是完全随机的错误技能,SDAR 依然能比纯 RL 更好。这证明了其门控机制能有效过滤由于技能质量不佳带来的噪音。
深度洞察与总结
SDAR 的成功通过训练动态图(Training Dynamics)得到了进一步印证。实验发现,即便大多数 token 的 Gap 是负的(教师并不比学生更强),SDAR 依然能从中挑出那些“教师真正发光”的时刻进行学习。
局限性与展望
尽管 SDAR 在性能上表现卓越,但目前它依然依赖于预定义的“技能库”(Skill Library)。未来的方向可能在于如何让模型在没有预设技能库的情况下,通过持续学习自主发现这些“特权信号”,实现真正的闭环自演进。
总结:SDAR 告诉我们,Agent 训练不应该是对教师的盲从,而应该是在强化学习的基础上,通过自适应门控有选择地“吸取”高价值的密集信号。