
SDAR:让智能体在强化学习中实现“自适应进化”与知识内化
Self-Distilled Agentic Reinforcement Learning
本文提出了 SDAR (Self-Distilled Agentic Reinforcement Learning),一种针对多轮交互智能体的自蒸馏强化学习方法。该方法通过在强化学习(GRPO)基础上引入带门控机制的 token 级自蒸馏(OPSD),成功在 ALFWorld、WebShop 等任务中刷新 SOTA。
TL;DR
在多轮交互 Agent 的训练中,单纯靠环境奖励(RL)太慢,靠老师教(蒸馏)又容易教歪。SDAR (Self-Distilled Agentic Reinforcement Learning) 提出了一种聪明的折中方案:它为每个 Token 设计了一个“自动调节阀(Sigmoid Gate)”。只有当老师(带特权信息的模型)表现明显优于学生时,才开启蒸馏;否则,坚持以环境反馈为主。该方法不仅解决了多轮训练崩溃的痛点,还让模型在推理时不带“技能书”也能表现卓越。
1. 痛点深挖:多轮 Agent 训练的两大坑
目前的 LLM Agent 训练正处在从“单轮推理”向“多轮交互”进化的关键期。然而,开发者们发现现有的 OPSD(On-Policy Self-Distillation)在 Agent 场景下水土不服:
- 多轮不稳定性 (Multi-turn Instability):由于 Agent 的每一步都会改变环境,一旦学生在某一步走歪了,老师给出的 Token 级指导就会产生漂移,导致 KL 散度激增,训练崩溃(见图 2 左侧)。
- 特权信息的“不对称信任”问题:老师之所以强,是因为它在训练时能看到额外的“技能文件”或“参考答案”。但如果检索到的技能本身就是错的呢?盲目跟随老师会把学生带入歧途。
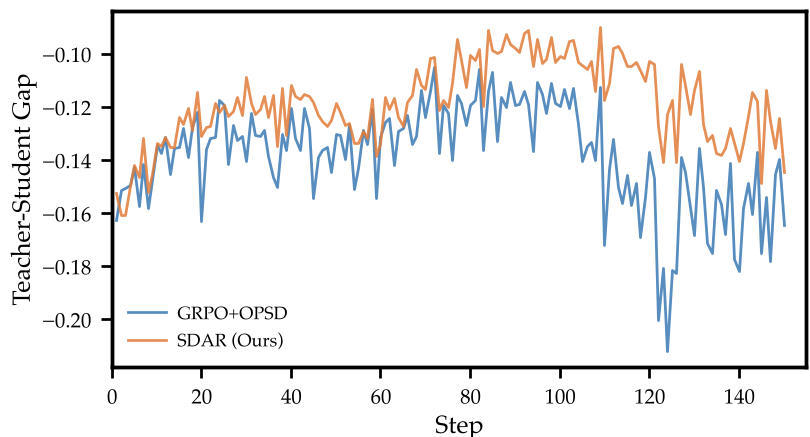 图1:SDAR 与传统 GRPO+OPSD 的对比,显示了 SDAR 如何通过辅助目标实现跨越式提升。
2. 核心方法论:带着门控的“辅助教学”
SDAR 的精髓在于它并没有把蒸馏作为硬指标,而是将其作为 带门控的辅助目标 (Gated Auxiliary Objective)。
2.1 自动调节阀:Token-Level Gating
作者引入了 (老师与学生对当前 Token 的对数概率差)。基于此,SDAR 定义了一个 Sigmoid 门控 :
- 当 为正(正面信号):老师非常确信某一动作是对的,且学生还没掌握, 趋近于 1,强化蒸馏。
- 当 为负(负面信号):老师可能也被错误的特权信息误导了, 变小,减少干扰,让模型更相信 RL 带来的环境真实反馈。
2.2 架构解析
SDAR 并不改变 GRPO 的核心逻辑,从而保证了强化学习优势函数的无偏性。它像是在一个高效的发动机(RL)旁边加装了一个高精度的增压器(SDAR Distillation),只有在需要加速时才介入。
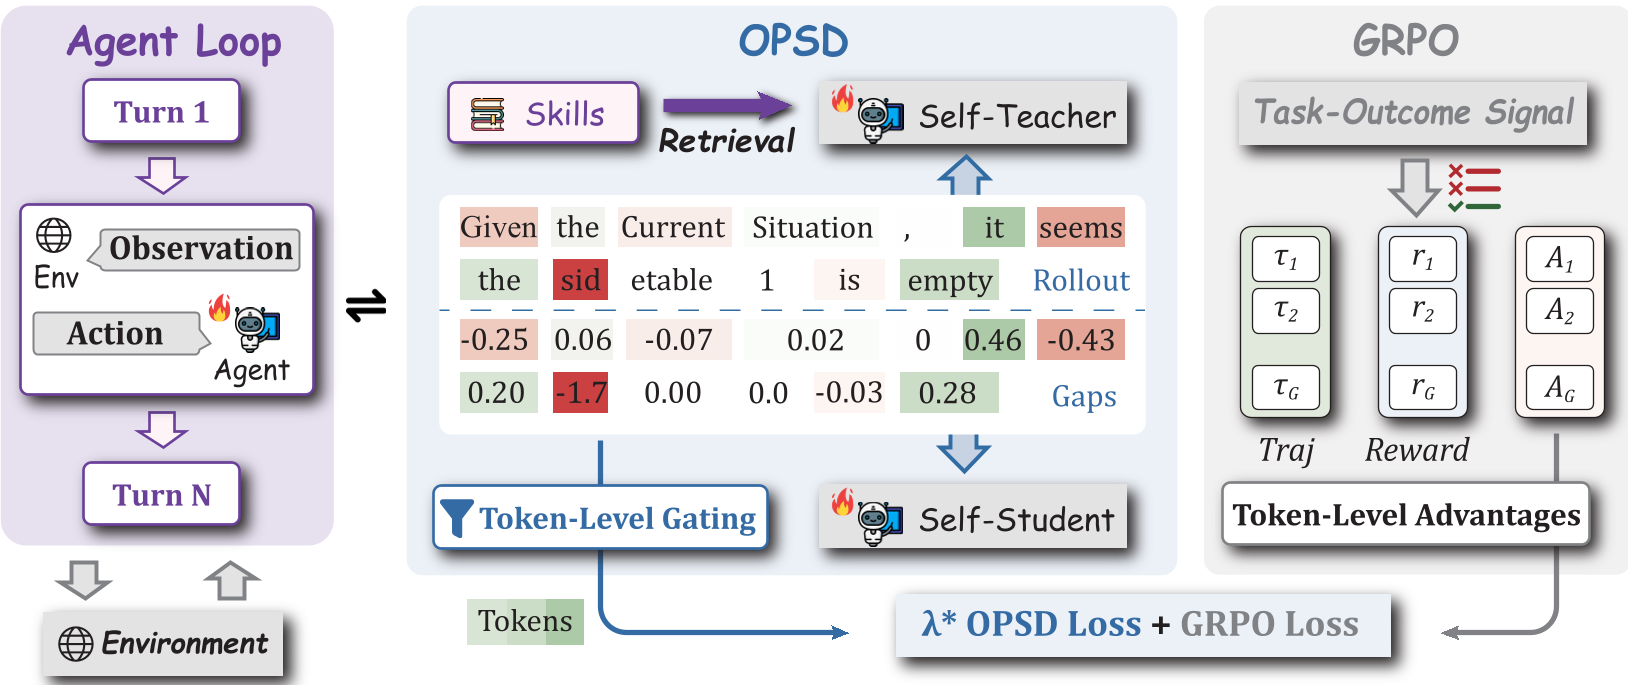 图2:SDAR 框架图,展示了从环境交互到 Token 级门控蒸馏的完整闭环。
3. 实验战绩:全线飘红
在三个高难度基准测试中,SDAR 展现了极强的统治力:
- ALFWorld (具身智能任务):在 Qwen2.5-3B 上,相比纯 GRPO 成功率从 75% 提升至 84.4%。
- WebShop (电商交互):在 7B 模型上,准确率相比基线提升了 10.2%。
- 知识内化的奇迹:最亮眼的一点是,即便在推理阶段 完全不给参考技能,SDAR 训练出的模型依然超越了那些“边查书边做题”的基线模型(Skill-GRPO*)。这说明模型真正把知识“吃”进去了。
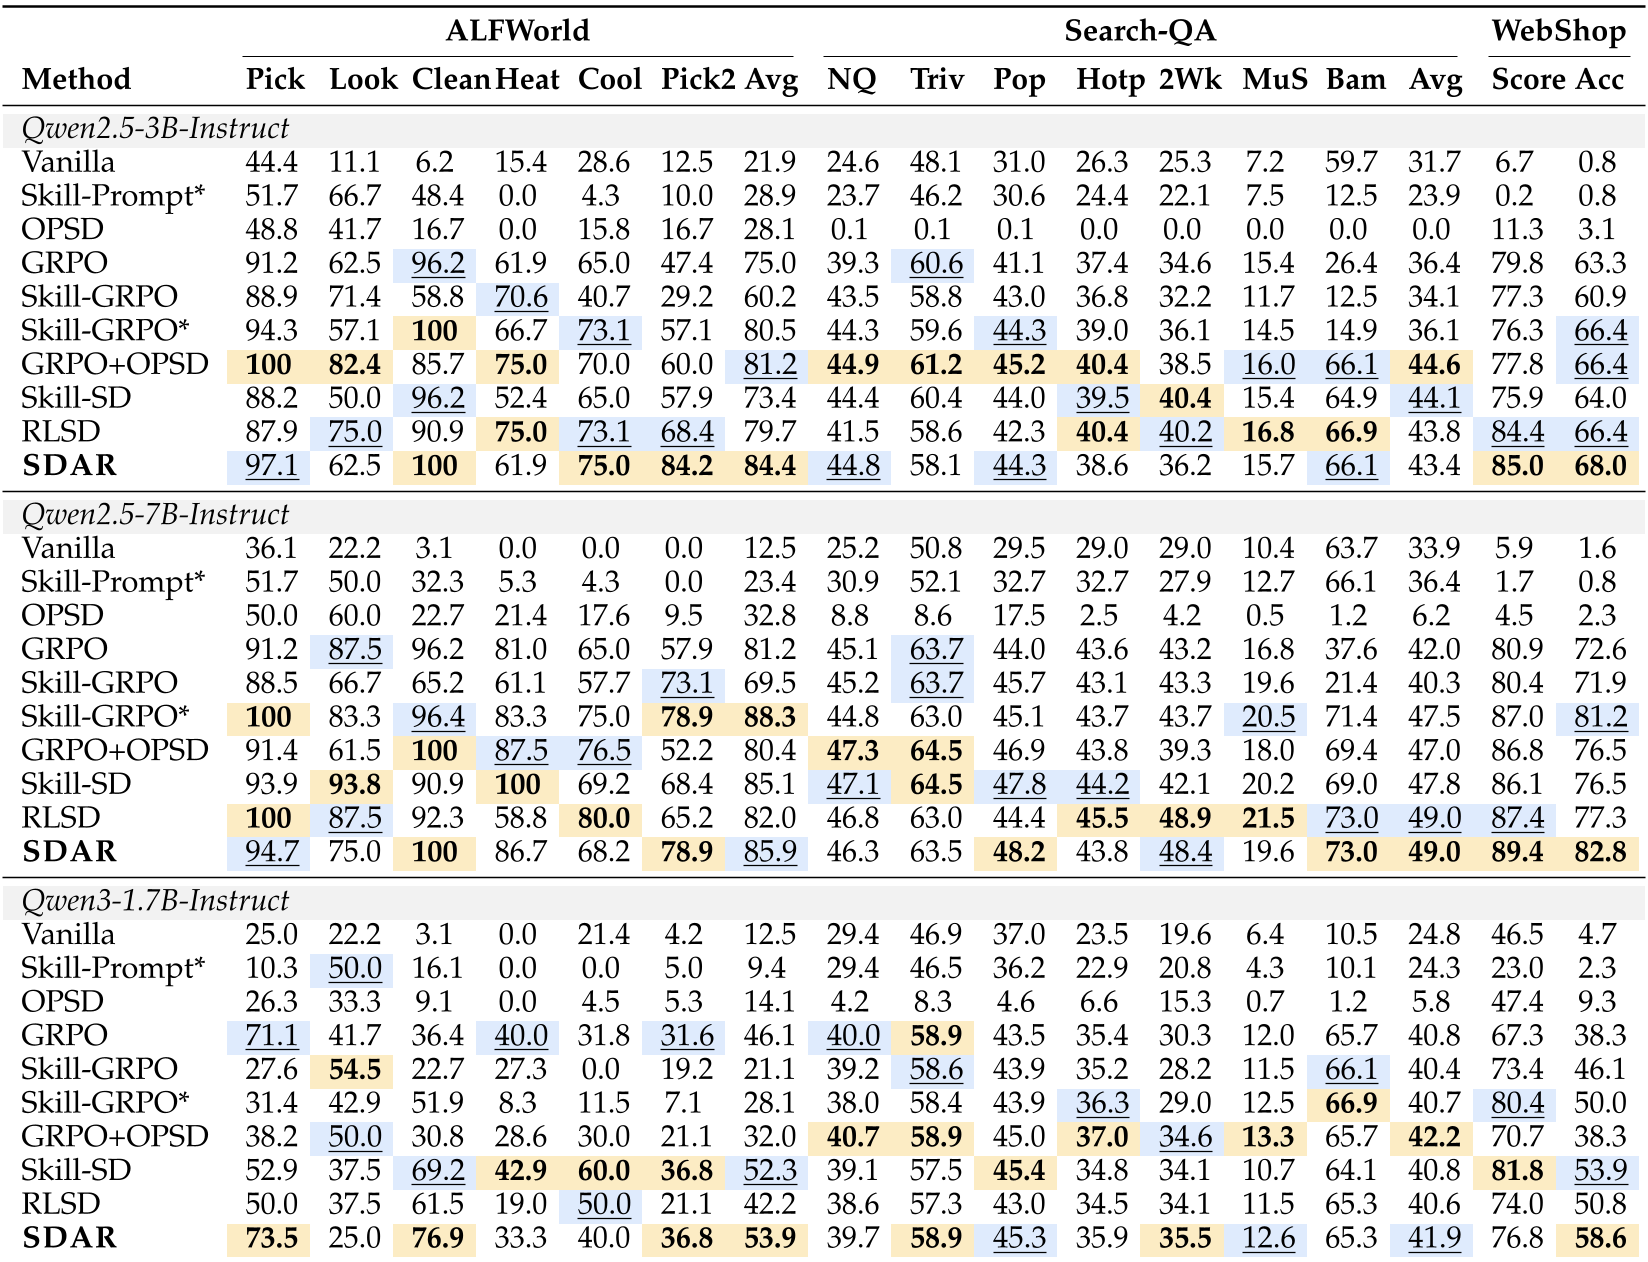 表1:在不同规模(1.7B-7B)和不同环境下,SDAR 均保持了稳定的性能领先。
4. 深度洞察:为什么这种“软性引导”有效?
通过对训练动态的监控,我们发现:
- 在训练初期,门控激活率很低。这是因为学生和老师步调不一,SDAR 选择保守。
- 随着训练进行,学生逐渐跟上老师的节奏,门控激活率稳步上升(见图 5),形成了天然的 自节奏课程学习 (Self-paced Curriculum)。
5. 总结与展望
SDAR 为多轮 Agent 的训练提供了一个优雅的范式:RL 定下限,蒸馏提上限,门控保稳定。
局限性:尽管其对检索波动的鲁棒性很高,但在极端动态或老师性能完全劣于学生的场景下(如极复杂的创新博弈),这种依赖“老师-学生差”的逻辑可能需要更精细的奖励建模。
未来展望:这种 Token 级别的门控思想完全可以迁移到多模态生成或实时代码纠错中,让模型在“听取专家建议”和“自我探索”之间达成完美的动态平衡。
Takeaway: SDAR 告诉我们,教 Agent 就像教学生,不要强迫他背诵每一行公式,而要在他在关键处感到困惑且你确实有更好见解时,推他一把。