
缓存中的阴影:揭秘并抵御 LLM 推理中 KV-cache 的隐私风险
Shadow in the Cache: Unveiling and Mitigating Privacy Risks of KV-cache in LLM Inference
本文系统揭示了 LLM 推理加速核心技术 KV-cache 的严重隐私漏洞,提出了三种攻击向量(Inversion, Collision, Injection)实现从缓存中还原用户明文输入。针对此威胁,作者开发了 KV-Cloak 辩护机制,通过可逆矩阵混淆与算子融合技术,在保持模型 SOTA 精度零损耗的同时,将推理额外开销控制在 1% 以内。
TL;DR
Key-Value (KV) cache 是 LLM 能够实现极速推理的功臣,但它也是一个巨大的“隐私后门”。本研究首次证实,攻击者可以通过拦截明文缓存直接还原你的敏感对话。为了解决这一问题,研究团队推出了 KV-Cloak——一个既能通过复杂的数学混淆保护数据,又几乎不会拖慢推理速度(开销 < 1%)且精度零损耗的防御方案。
1. 为什么 KV-cache 会成为隐私黑洞?
在 autoregressive(自回归)生成过程中,为了避免重复计算,模型会将之前 token 的 Key 和 Value 向量存入 KV-cache。
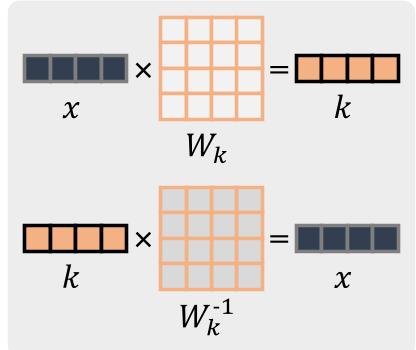
- 物理关联性:KV 向量与原始 token 存在直接的线性映射关系,像是一张未加密的“指纹表”。
- 架构暴露:在当前的云推理(MaaS)架构中,KV-cache 往往为了性能而以明文形式存储在内存或持久化池中,这为攻击者提供了天然的侧信道或直接访问机会。
2. 三种毁灭性的攻击向量
作者设计了由浅入深的攻击手段:
- Inversion Attack (反演攻击):利用已知的权重矩阵进行代数求逆。虽然对现代 GQA 架构有局限,但在 Layer 0 的还原度极高。
- Collision Attack (碰撞攻击) —— 本文杀手锏:这是一种通用型攻击。攻击者通过本地模拟推理构造“词表指纹”,在拦截到的缓存中寻找统计学上的“异常点(Outliers)”。实验显示,即使不知道模型经过了何种微调,该攻击也能以接近 100% 的精度还原输入。
- Injection Attack (注入攻击):通过在缓存后拼接“Repeat the previous content”等指令,诱导模型自己吐出隐私内容。
3. KV-Cloak:防御的艺术
现有的方案要么太慢(加密),要么太糙(加噪声导致模型变笨)。KV-Cloak 走了一条聪明的路:可逆矩阵混淆 + 算子融合。
核心直觉
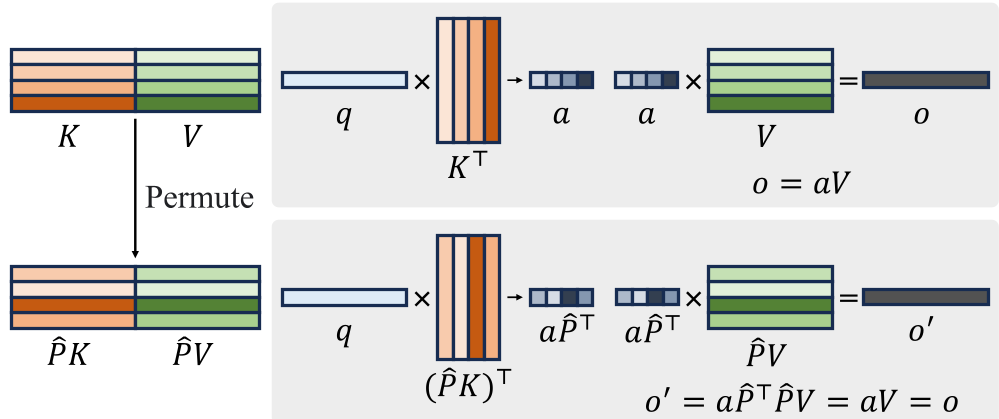
既然 KV 向量是通过 计算出来的,那如果我们把 变成 ,就能得到混淆后的 。只要我们在注意力计算时,同时引入 ,根据结合律,中间的混淆就会相互抵消,而外人看到的始终是乱码。
关键组件
- 块级动态置换:通过一次性随机洗牌打破 Token 间的物理顺序。
- 自适应 Beacon (信标):在混淆矩阵中埋入高幅值信号,实现“无存储密钥找回”,进一步降低存储开销。
- RoPE 兼容性:通过将混淆矩阵 设计为块对角结构,完美兼容了 Llama 等主流模型采用的旋转位置编码。
4. 实验战绩
研究团队在 Llama-3, Qwen 等多种模型上进行了严苛测试:
- 安全性:防护后的 Collision Attack 成功率直接降至 0,统计分布与随机噪声无异。
- 精度损耗:在 MMLU 等主流 Benchmark 上,KV-Cloak 实现了 Zero-degradation(零退化)。相比之下,差分隐私(DP)方案在保护隐私的同时,模型精度几乎腰斩。
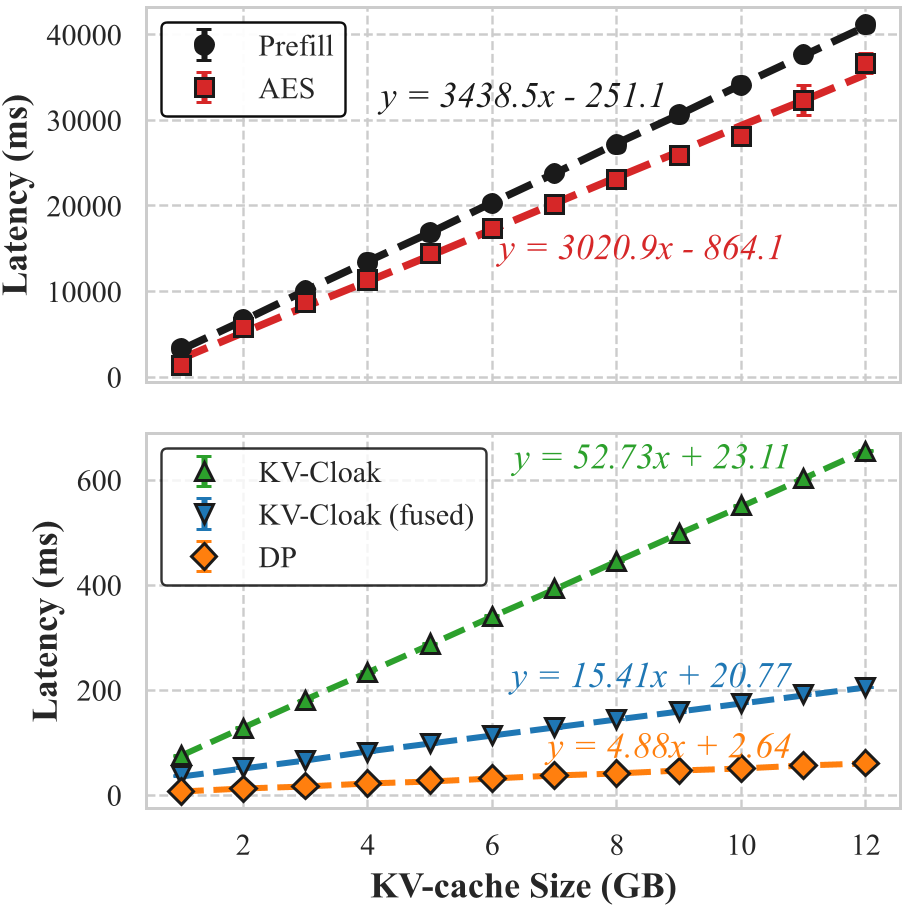
- 性能开销:由于采用了算子融合技术,推理延迟仅增加 15.41 ms/GB。这意味着如果你在读一条长消息,安全模块带来的延迟感几乎不存在。
5. 资深总编点评
这篇论文的价值在于:它不仅是第一个系统性地戳破 KV-cache 隐私泡沫的工作,更最提供了一个具备工业级落地潜力的防御模型。KV-Cloak 的设计哲学——“把复杂留给离线(权重融合),把简单留给在线(轻量矩阵运算)”,是未来机密计算(Confidential Computing)领域非常值得借鉴的思路。
对于开发者而言,如果你的大模型应用涉及敏感数据(如医疗、金融或企业私域),那么仅仅加密交互链路是不够的,KV-cache 的透明化防守必须提上日程。
Takeaway: 隐私保护不应以牺牲性能为代价,KV-Cloak 证明了通过精妙的代数设计,安全性、效率与精度可以三位一体。