
驯服思考者:CES 框架实现 LLM 自适应推理寻优
Taming the Thinker: Conditional Entropy Shaping for Adaptive LLM Reasoning
本文提出了 Conditional Entropy Shaping (CES),一种基于强化学习的自适应 LLM 推理框架。通过在 DAPO 基础上动态调节 Token 级熵,该方法在 DeepSeek-R1-Distill-7B 上实现了精度提升 (+2.5%) 与响应长度缩减 (平均减少 411 tokens) 的双赢。
TL;DR
在推理模型竞逐长链思维 (CoT) 的当下,DeepSeek-R1 等模型虽强,但常因在简单问题上“废话连篇”而饱受诟病。本文介绍的 Conditional Entropy Shaping (CES) 框架,通过对 Token 级熵的动态塑形,让模型学会了:简单题直接说答案,复杂题深思熟虑。 在 7B 模型上,它不仅将数学任务精度提升了 2.5%,还把平均码字量砍掉了 400 多个 Token。
1. 痛点:越变越“笨”的聪明模型?
当前的 LLM 推理存在一个悖论:为了提高准确率,我们鼓励模型进行长 CoT 探索;但这导致了严重的过度思考 (Overthinking)。比如问模型“2+3等于几”,它可能也要来一段几百字的思维链。
现有的优化方案往往走极端:
- 效率派:硬性限制长度,导致复杂问题因推导不足而报错。
- 性能派:通过奖励探索行为提高精度,却让回复变得更加臃肿。
作者敏锐地发现:CoT 路径中那些高熵 (High-entropy) 的 Token 往往是逻辑的“分叉点 (Forking Points)”。如果我们能根据结果的正确性,动态引导这些分叉点的行为,是否能打破“效率-精度”的死锁?
2. 核心机制:条件熵塑形 (CES)
CES 的设计哲学非常直观:胜不娇,败不馁,按需投入。
2.1 双向控制策略
该框架在 DAPO 强化学习流程中介入,对 Token 级的 Advantage 进行重新塑形:
- 路径正确 ():对高熵 Token 施加惩罚。这迫使模型在已知正确路径上变得更“果断”,剔除冗余修辞。
- 路径错误 ():对高熵 Token 给予奖励。这鼓励模型在遇到挫折时去大胆尝试不同的逻辑分支,寻找纠错机会。
2.2 动态干预强度
CES 不一味惩罚。它引入了一个动态倍率 ,根据同组样本的准确率 来调节。如果一个题大家都能做对(简单题),惩罚就重一些,逼模型瘦身;如果这题很难,即使做对了也会轻微惩罚,保护其来之不易的正确逻辑。
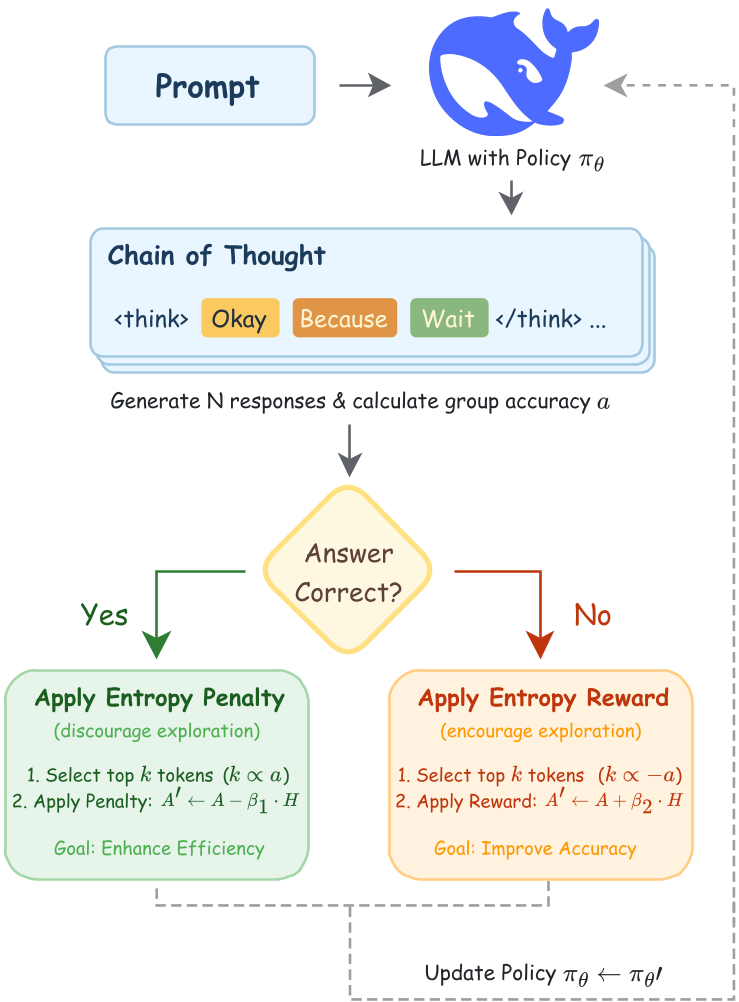 图 1:CES 的核心控制逻辑流程
3. 实验战绩:全线飘红的“减重”效果
作者在 DeepSeek-R1-Distill-Qwen-7B 上进行了验证。
- 数学全能王:在 AIME24、AMC23 等 12 个榜单上平均表现优于 DAPO 基准。
- 极致效率:在 AIME24 这种硬核竞赛题上,准确率暴涨 6.7%,长度却缩短了近 1000 个 Token。
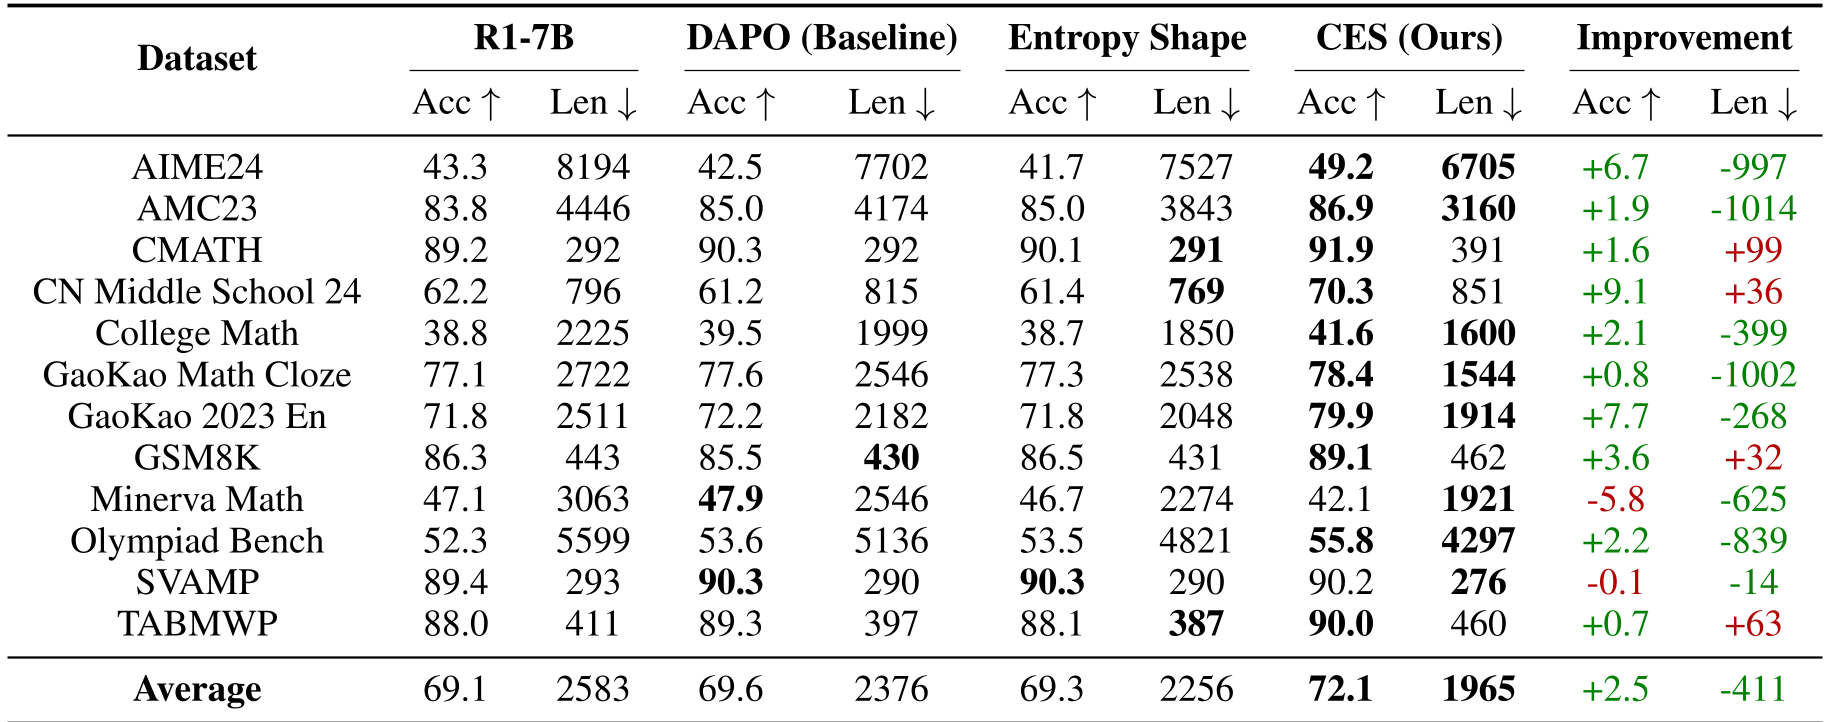 表 1:12 个数学基准测试中的性能对比
有趣的是,在 GSM8K 等简单数据集上,长度反而略有增加。分析发现,这是因为 CES 识别出了原模型在简单题上的“偷懒”失败案例,通过增加少量长度换取了大幅的精度提升——这正是自适应推理的体现。
4. 深度洞察:为什么熵梯度如此重要?
在消融实验中,作者揭示了两个关键发现:
- 动态倍率 是护身符:去掉根据准确率动态调节的机制后,模型性能直接跌回基准。如果没有这种“ calibrated intelligence”,模型会因粗暴惩罚复杂题的正确解法而变得迷茫。
- 梯度必须回传:与前人工作不同,CES 在优化时不使用
detach()。这意味着模型在训练中被显式要求学习“降低不确定性”。
5. 局限性与展望
尽管 CES 表现惊艳,但它目前依赖于可验证的结果 (Outcome-verifiable)(如数学题有唯一答案)。对于主观创作或没有标准答案的文本生成,如何定义“正确路径”并进行熵塑形,仍是未来的挑战。
总结
CES 证明了 LLM 能够学会“自我调节”。它不仅在算力日益昂贵的今天具有极高的工程价值,也为通往更智能、更高效的推理架构提供了理论支持。未来,我们或许不再需要根据任务难度选择不同的模型模型,因为模型本身就能像人类一样,在草稿纸上动态决定到底要写多长。