
通义 DeepResearch:开启开源 AI 研究员时代,3.3B 激活参数下的深度检索巅峰
Tongyi DeepResearch Technical Report
本文介绍了 Tongyi DeepResearch,这是一个由阿里巴巴通义实验室开发的 30.5B 参数(激活 3.3B)的智能代理大模型,专门用于处理长程、深度信息寻检任务。该模型通过端到端的 Agentic Mid-training 和 Post-training 框架,在 Humanity’s Last Exam 等多个深度研究基准测试中达到了 SOTA 性能。
TL;DR
阿里巴巴通义实验室(Tongyi Lab)近日发布了 Tongyi DeepResearch,这是一个旨在替代人类进行数小时网页调研的智能代理模型。它通过独创的“Agentic Mid-training(代理化中间训练)”和“Context Management(上下文管理)”技术,仅凭 3.3B 的激活参数量,就在包括 Humanity's Last Exam 在内的 7 个主流深度研究榜单上刷新了 SOTA 记录,甚至在多数指标上超越了 OpenAI o3 和 DeepSeek-V3.1。
1. 深度研究的“不可能三角”:复杂性、成本与开源
在 AGI 的演进中,“深度研究(Deep Research)”被视为最高级的代理能力。它要求模型在数十分钟内,自主规划、搜索信息、验证结论并撰写报告。然而,该领域面临三个核心痛点:
- Inductive Bias 缺失:通用模型在海量文本上预训练,缺乏“工具调用-反馈-调整”的直觉。
- 标注成本爆炸:一个高质量的研究轨迹往往包含数十个步骤,人工标注一个样本需要数小时。
- 上下文窒息:长时间的网页浏览会产生海量无效信息,导致模型在处理 128K 窗口时依然会迷失。
2. 核心架构:像人类一样“分段思考”
通义团队认为,传统的 ReAct 模式在面对超长任务时会因上下文过载而失效。为此,他们引入了 Markovian State Reconstruction(马尔可夫状态重构) 机制。
上下文管理范式
模型不再被迫记忆所有的原始搜索结果,而是在每一步生成一个不断进化的报告(S_t)。这个报告充当了模型的“压缩内存”,每一步的决策仅基于:
当前报告 + 上一步动作 + 环境反馈。
这种设计不仅防止了上下文溢出,还强制模型在每一步进行信息的优先级排序和综合,模拟了人类研究员“一边查资料,一边改草稿”的习惯。
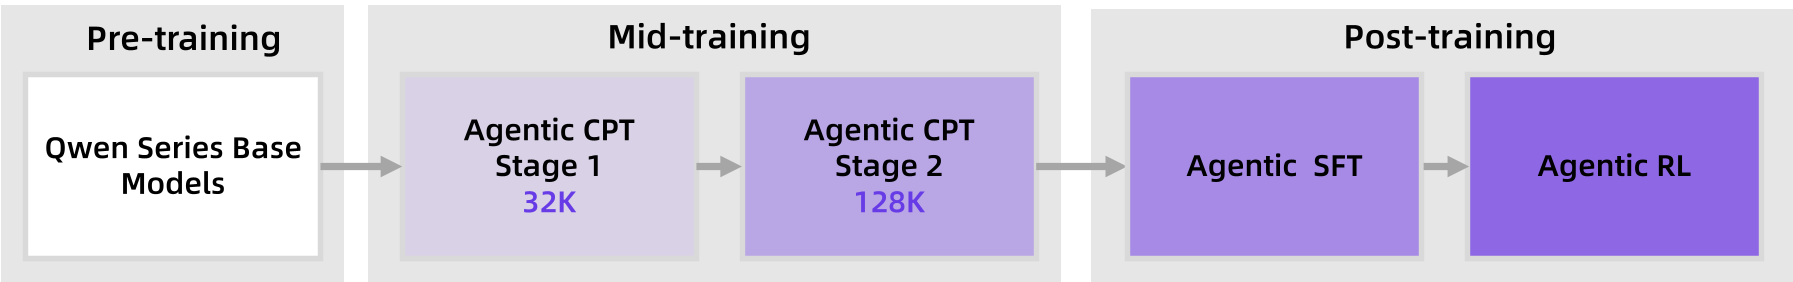 图 1:通义 DeepResearch 的端到端训练流程,包含 Mid-training、SFT 和 RL
3. 训练三部曲:从“模仿”到“自主”
不同于常见的预训练+微调,通义 DeepResearch 引入了三个关键阶段:
- Agentic Mid-training:在预训练模型基础上,使用大规模合成的代理行为数据(规划、推理、决策)进行持续预训练,让模型提前感知“代理行为”的模式。
- SFT 冷启动:通过 rejection sampling(拒绝采样)筛选高质量路径,让模型学会基本的工具调用。
- 大规模异步 RL:利用改进的 GRPO 算法,在真实和模拟环境中进行上万次的 Rollout。为了解决环境不稳定问题,团队构建了一个统一下控中心(Sandbox),通过自动重试和缓存屏蔽了 API 的波动。
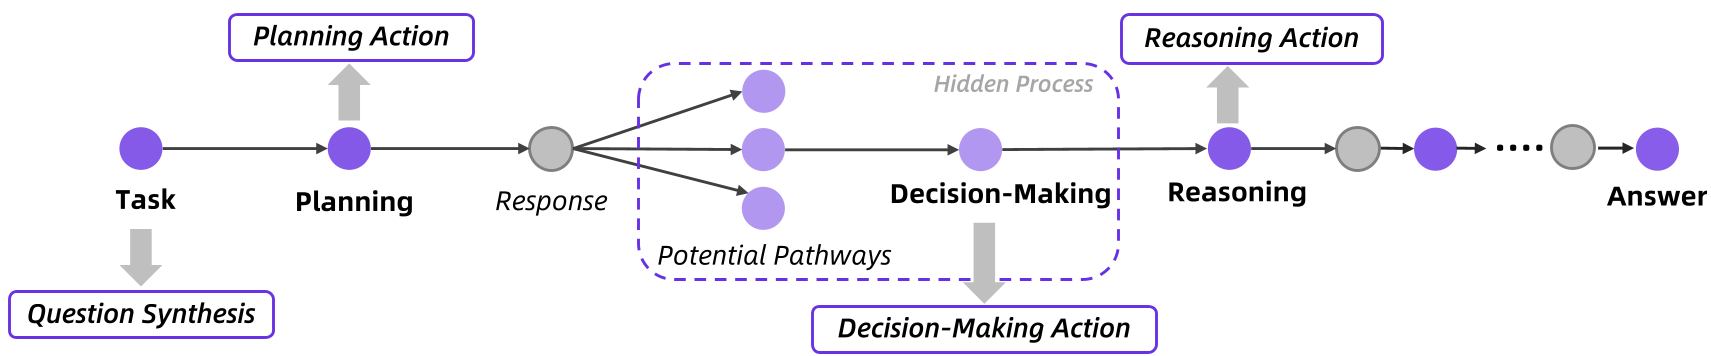 图 2:针对 Agentic CPT 的大规模代理行为数据合成流程
4. 实验战果:以小博大的极致效率
尽管 Tongyi DeepResearch 总参数量为 30.5B,但得益于 MoE 架构,每个 Token 仅激活 3.3B 参数。
- 综合战局:在 Humanity’s Last Exam(被认为是人类最难的考试)上得分 32.9%,显著超过 OpenAI o3(24.9%)。
- 中文深度检索:在 BrowseComp-ZH 榜单上不仅远超同量级模型,甚至在 Heavy Mode 下达到了 58.1% 的惊人准确率。
- Heavy Mode(重度模式):通过部署 n 个并行代理自主探索不同路径,最后由一个合成模型进行信息归并。这种“测试时计算缩放(Test-time Scaling)”极大提升了处理高不确定性问题的上限。
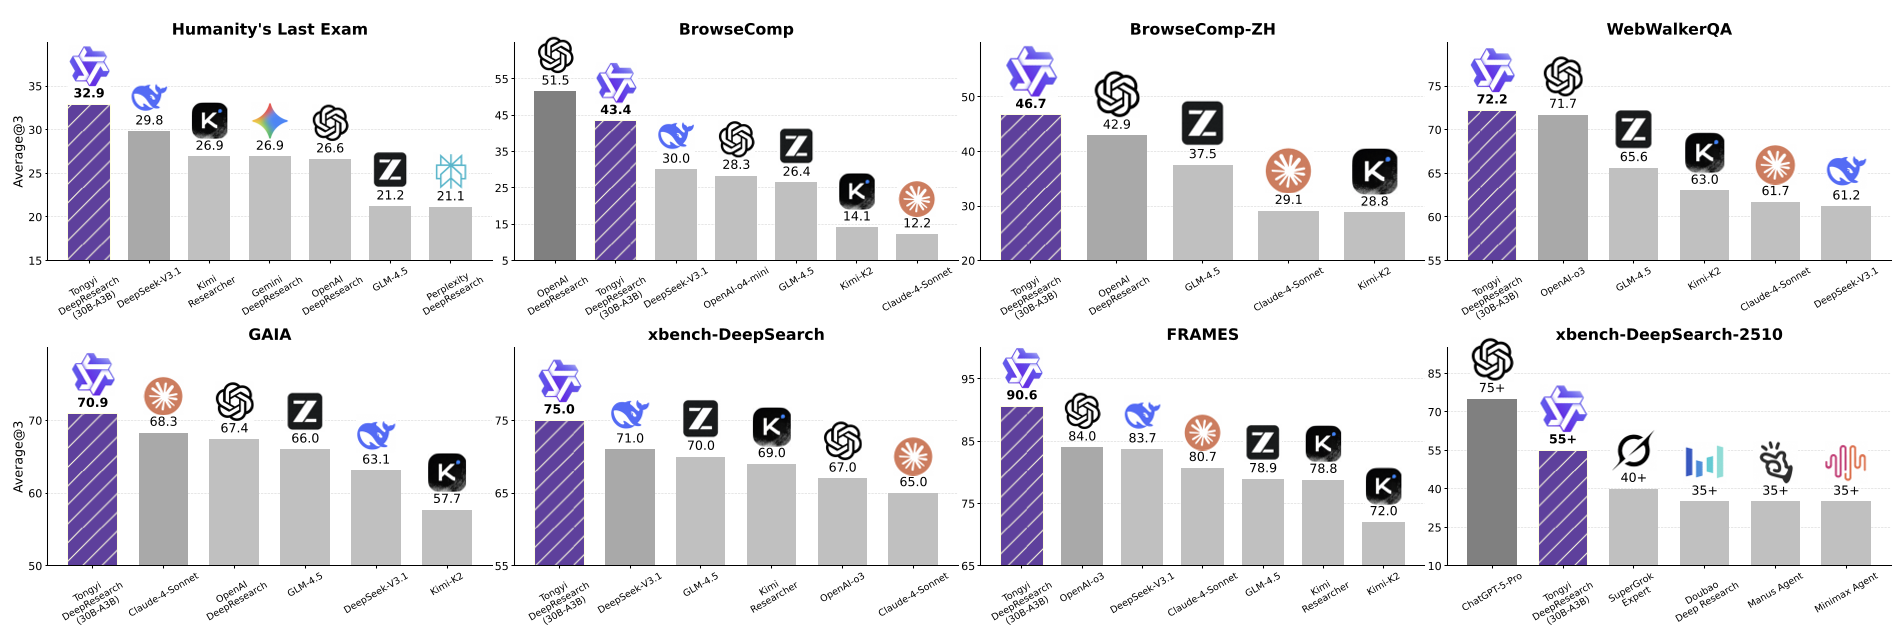 图 3:各主流 Benchmark 下的性能对比图
5. 局限性与展望
尽管表现强劲,通义团队坦言:128K 的上下文在处理极其复杂的科研任务时仍显局限,未来将探索更长窗口或更精细的记忆管理。同时,强化学习框架下的端到端训练仍然面临非平稳分布的挑战。
总结
Tongyi DeepResearch 的成功标志着:深度研究能力的习得不再仅仅依赖模型规模,而在于训练范式中对“交互过程”的深度建模。 通过开源模型、框架及解决方案,阿里通义实验室为社区提供了一个可落地、可复现的“数字研究员”蓝图。
相关资源:
- 模型权重:[HuggingFace-Link]
- 代码仓库:[GitHub-Link]