
视觉语言模型带来的范式革命:建筑工地安全隐患的“深度理解”
Using vision language models for safety hazard identification in construction
本文提出了一种基于视觉语言模型 (VLM) 的建筑工地安全隐患识别框架。该框架通过 Prompt Engineering 将安全准则转化为上下文查询,利用 GPT-4o, Gemini 1.5 Pro 等 SOTA 模型实现隐患自动检测与风险评估,并在 1100 张工地图像的测试中展现出极高的语义理解能力。
1. 核心速览
TL;DR: 本论文挑战了传统计算机视觉在工地安全监测中的“肤浅”表现。作者提出了一种基于 Vision Language Models (VLMs) 的通用框架,通过 Prompt Engineering 将复杂的安全法规注入模型。实验证明,GPT-4o 和 Gemini 等模型不仅能“看到”物体,还能通过语义推理判断“不安全的状态”,在隐患识别的准确度与灵活性上远超传统目标检测模型。
背景定位: 该研究处于从“特定任务小模型(Task-specific AI)”向“基础模型(Foundation Models)”迁移的前沿,是建筑领域利用 AIGC 技术实现主动式安全管理(Proactive Safety Management)的样板工程。
2. 痛点:实体检测不等于安全理解
在工地上,安全往往藏在“关系”中。
- 传统方法的局限: 现有的 YOLO 或 R-CNN 模型能准确检测出“工人”和“安全帽”,但它们很难感知复杂的上下文。例如:一个没戴安全帽的工人在休息室是安全的,但在吊装作业下则是高危的。
- 标注成本高昂: 传统 AI 需要数万张标注精良的工地图片进行训练,且每当安全法规更新时,模型就面临过时风险。
- 缺乏推理能力: 它们无法根据现场情况给出“这份风险有多严重”以及“下一步该怎么修补”的建议。
3. 核心机制:将法规转化为“理解力”
该研究的核心在于将 VLM 的零样本 (Zero-shot) 推理能力工程化。其流程分为两个核心阶段:
-
Prompt Engineering 模块: 利用 LLM 解析《职业安全与卫生指南》,生成结构化的 Instruction。例如,将“电火花风险”细化为“图像中是否存在磨削作业?周围是否有易燃物?”的逻辑链条。
-
VLM 推理模块: 模型同时“吃下”图像和上述指令。它不再只是输出一个边界框(Bounding Box),而是输出一份包含隐患总结、严重程度 (1-10)、逻辑解释、整改建议的完整报告。
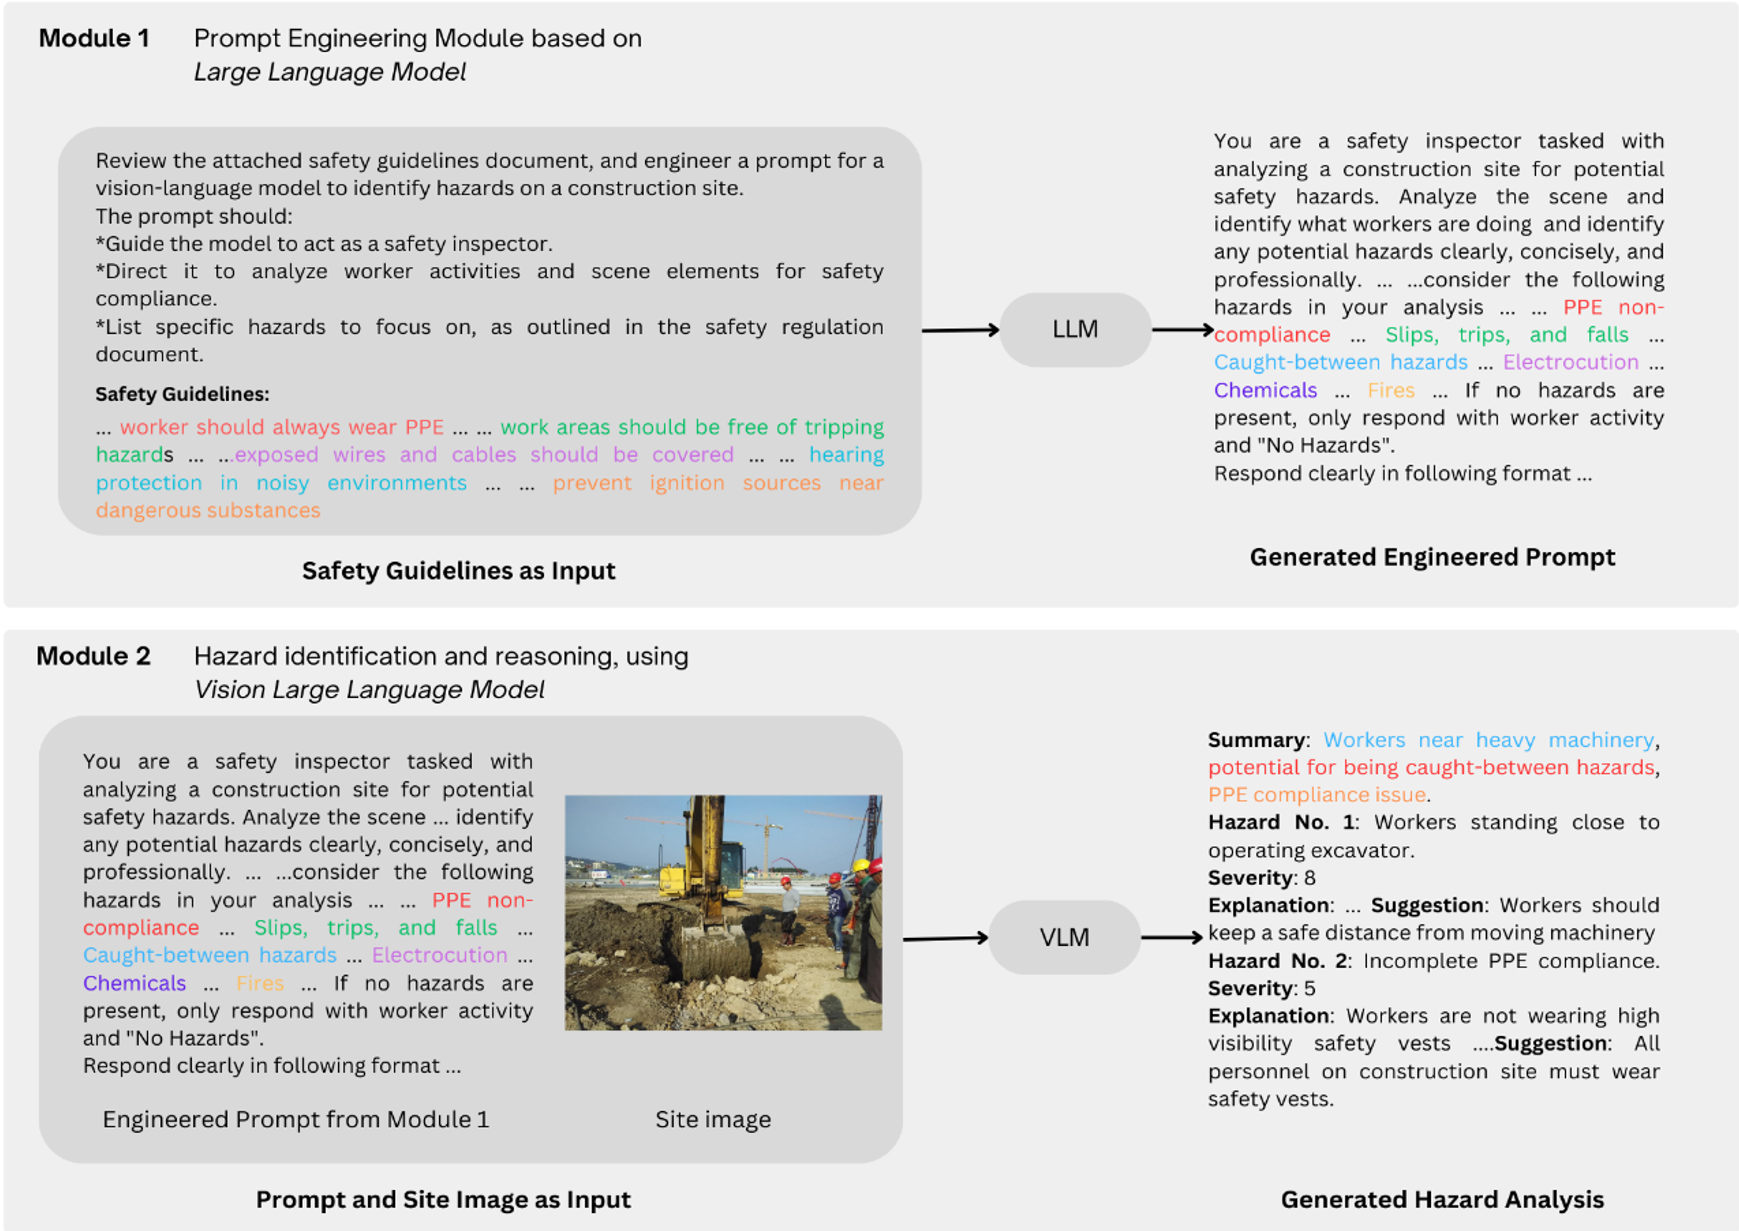 图 1:VLM 安全监测框架流程图,分为 Prompt 工程与隐患推理两大部分
4. 实验战绩:谁是最强安全卫士?
作者构建了一个包含 1100 张真实工地图片的测试集,横向对比了闭源 SOTA 模型与开源劲旅。
4.1 准确度对比
- 闭源霸主: GPT-4o 和 Gemini 1.5 Pro 在语义相似度(Cosine Similarity)和 BERTScore 上全面领先,能够识别极其复杂的交互隐患(如挖掘机边缘的坍塌风险)。
- 开源黑马: InternVL2-8B 和 Llama 3.2-11B 表现亮眼,在保持较低参数规模的同时,得分逼近 GPT 系列,显示出本地化部署的巨大潜力。
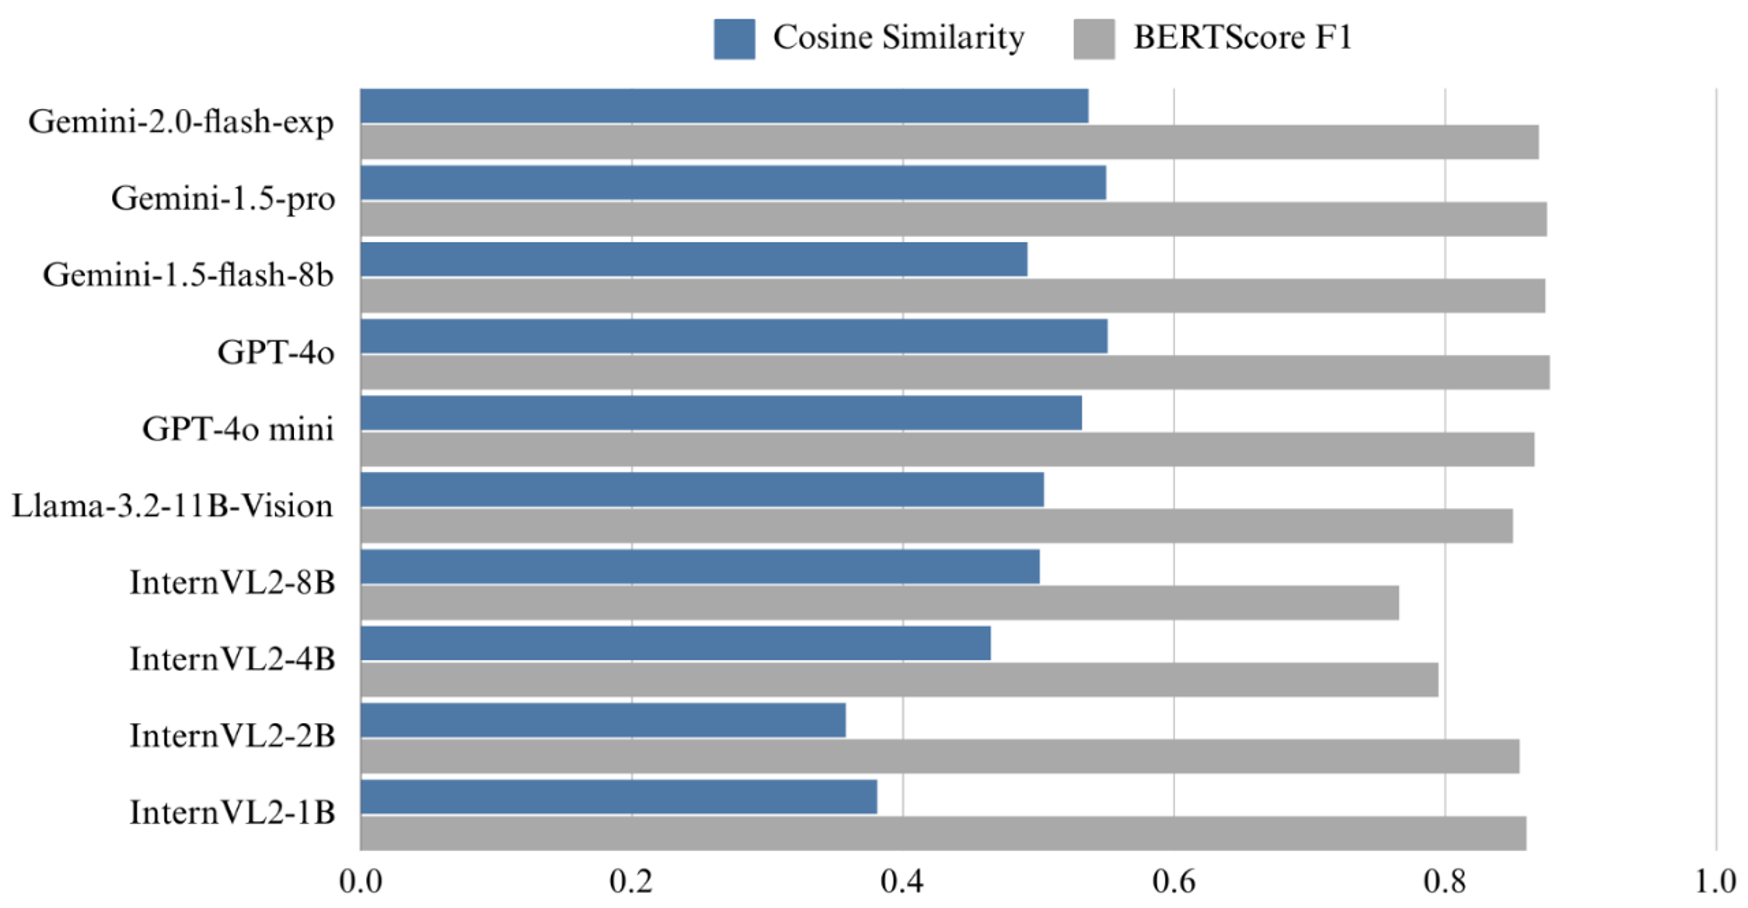 图 2:各模型隐患检测准确率对比,GPT-4o 在 Cosine Similarity 上居于首位
4.2 推理速度的“硬伤”
虽然 VLM 聪明,但它们目前还不够“快”。
- Gemini 2 Flash: 达到了 0.94s/图的惊人速度,勉强接近准实时。
- Llama 3.2-11B: 在 A6000 GPU 上需要 8.4 秒处理一张图。对于瞬息万变的工地,这种延迟是目前部署的最大障碍。
5. 深度洞察:还存在“幻觉”吗?
尽管表现卓越,论文也坦诚了一些典型失败案例:
- 模型幻觉 (Hallucination): 偶尔会无中生有,将正常的架子说成是“未固定的脚手架”。
- 空间关系误判: 在处理“工人是否系了安全绳”这种细粒度视觉任务时,模型有时会产生干扰。
- 上下文局限: 对于某些极其依赖动态过程(如观察某个支撑物晃动)的隐患,单张静态图片仍显不足。
6. 总结与未来展望
核心启示: 本研究证明了 VLM 已经具备了“安全专家”的初步直觉。未来的研究重心将在于:
- 模型剪枝与量化: 如何在嵌入式设备上运行这些大模型。
- 视频流分析: 从 Static Image 转向 Video-based VLM,消除静态图片的理解盲区。
- 人机协同 (Human-in-the-loop): AI 进行初筛,专家进行最后确认,形成高效的闭环。
这不仅仅是技术的更迭,更是建筑工地管理从“被动响应”向“预知风险”跨越的关键一步。